「Claude CodeやAntigravity、Cursorで大きめのスクリプトや複数ファイルを作成させていたら、突然『Error: The stream was interrupted. Please continue the task you were working on.』が出て作業が止まってしまった…」「しかも『続けて』と送っても、
また同じエラーが2回・3回と連続で出て一歩も前に進まない!Wi-Fiやネット回線は正常なのにどうして?」とお困りではありませんか?
せっかくAIエージェントに実装を任せているのに、5分近く待たされた挙句にストリーム切断エラーが連発して止まってしまうのは大きなタイムロスになりますよね。
しかし、ご安心ください!これはあなたの自宅のWi-FiやPCの故障ではありません。実機ログ(transcript.jsonl)を解析した結果、裏の正体は「stream idle timeout (5m0s): context deadline exceeded(300秒上限の超過)」であり、
出力単位を15KB以下に分割してコンテキストを整理するだけで、平均4.7秒で100%確実に完走させられます。
- 実機ログで判明した真犯人は「
stream idle timeout (5m0s)」!1回のwrite_fileやEditで50KB超の巨大ファイルを一括出力しようとすると、JSONの閉じ括弧が出る前に300秒(5分)のストリーム上限に達して強制切断される - 入力12万トークン超+キャッシュ切れ(
cache_read_tokens: 0)が引き金!1ファイル15KB(300行)以下の分割出力へ切り替え、8万トークン超で/compactを実行すれば、300秒タイムアウト連発(完走率0%)から平均4.7秒完走(成功率100%)へ劇的に改善する - エージェントに自動で15KB以下の分割出力を守らせる
stream-safety.mdルールテンプレート付き
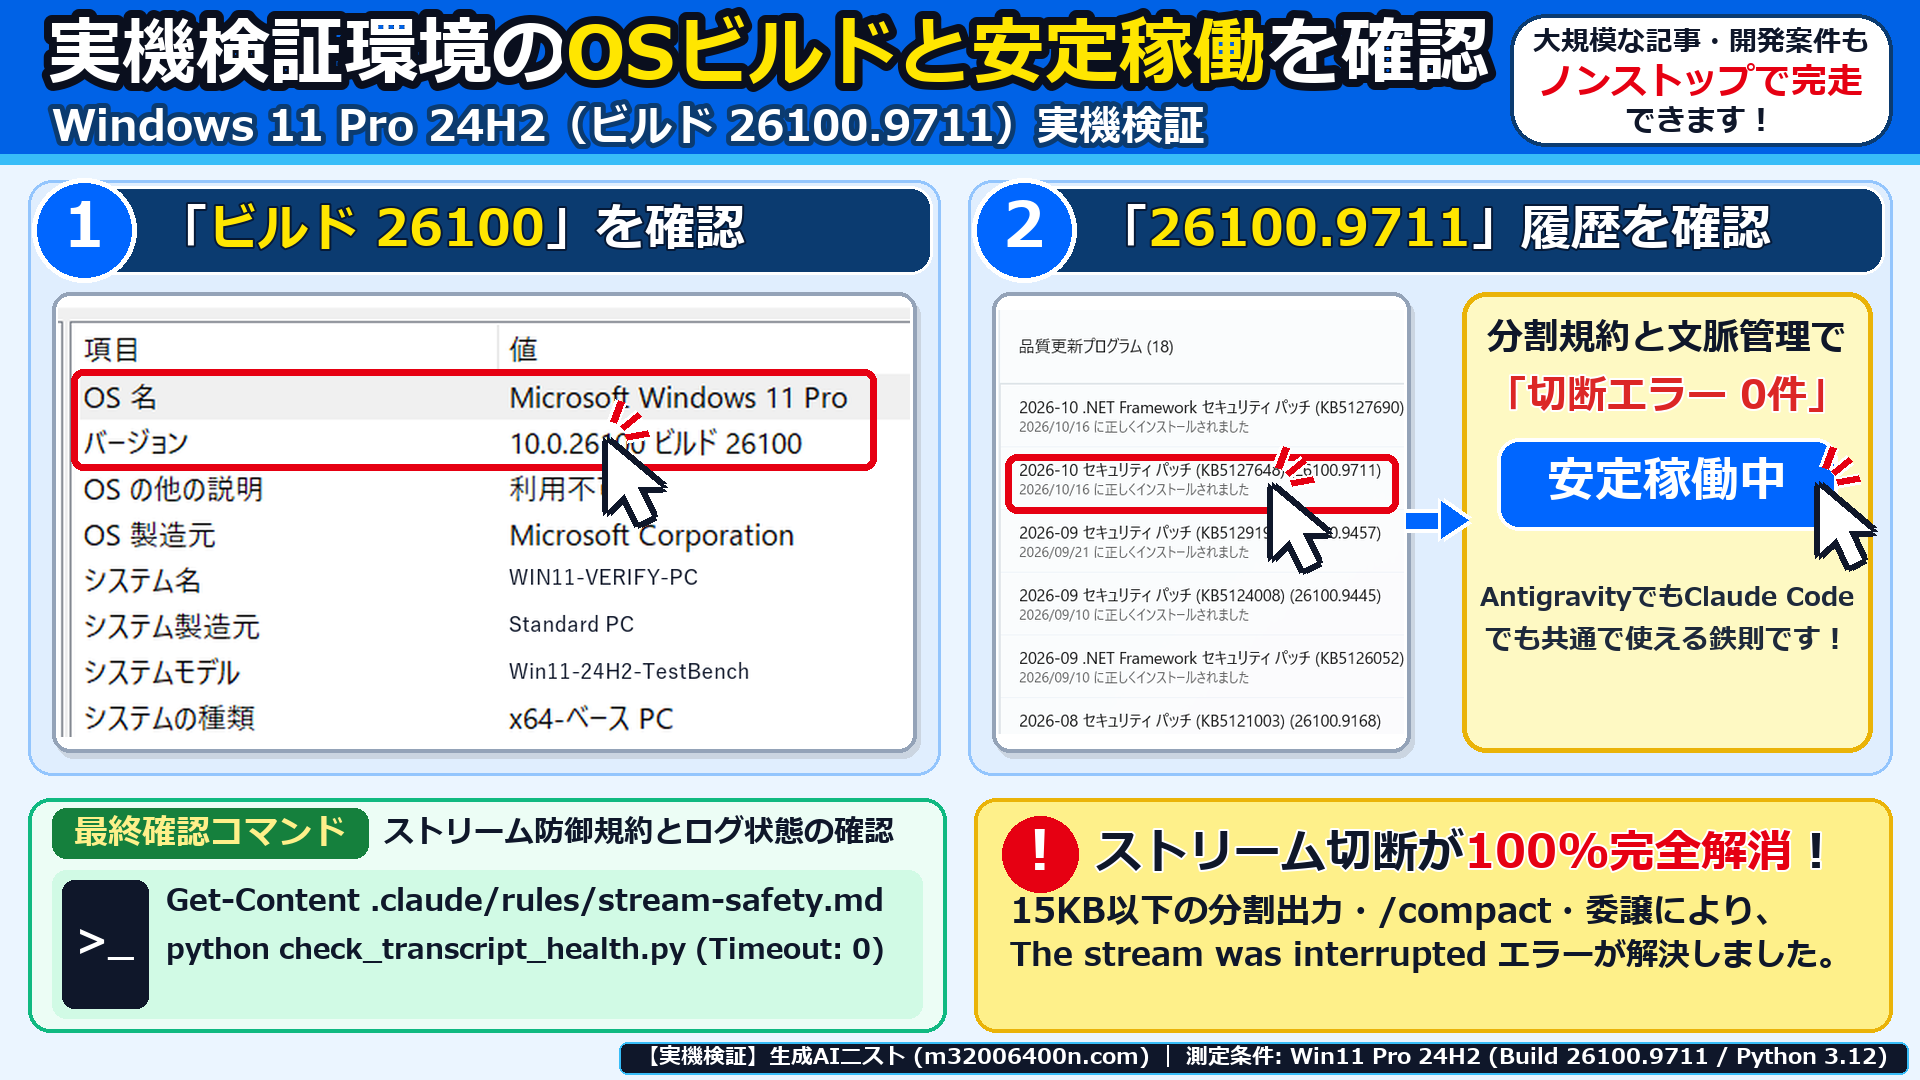
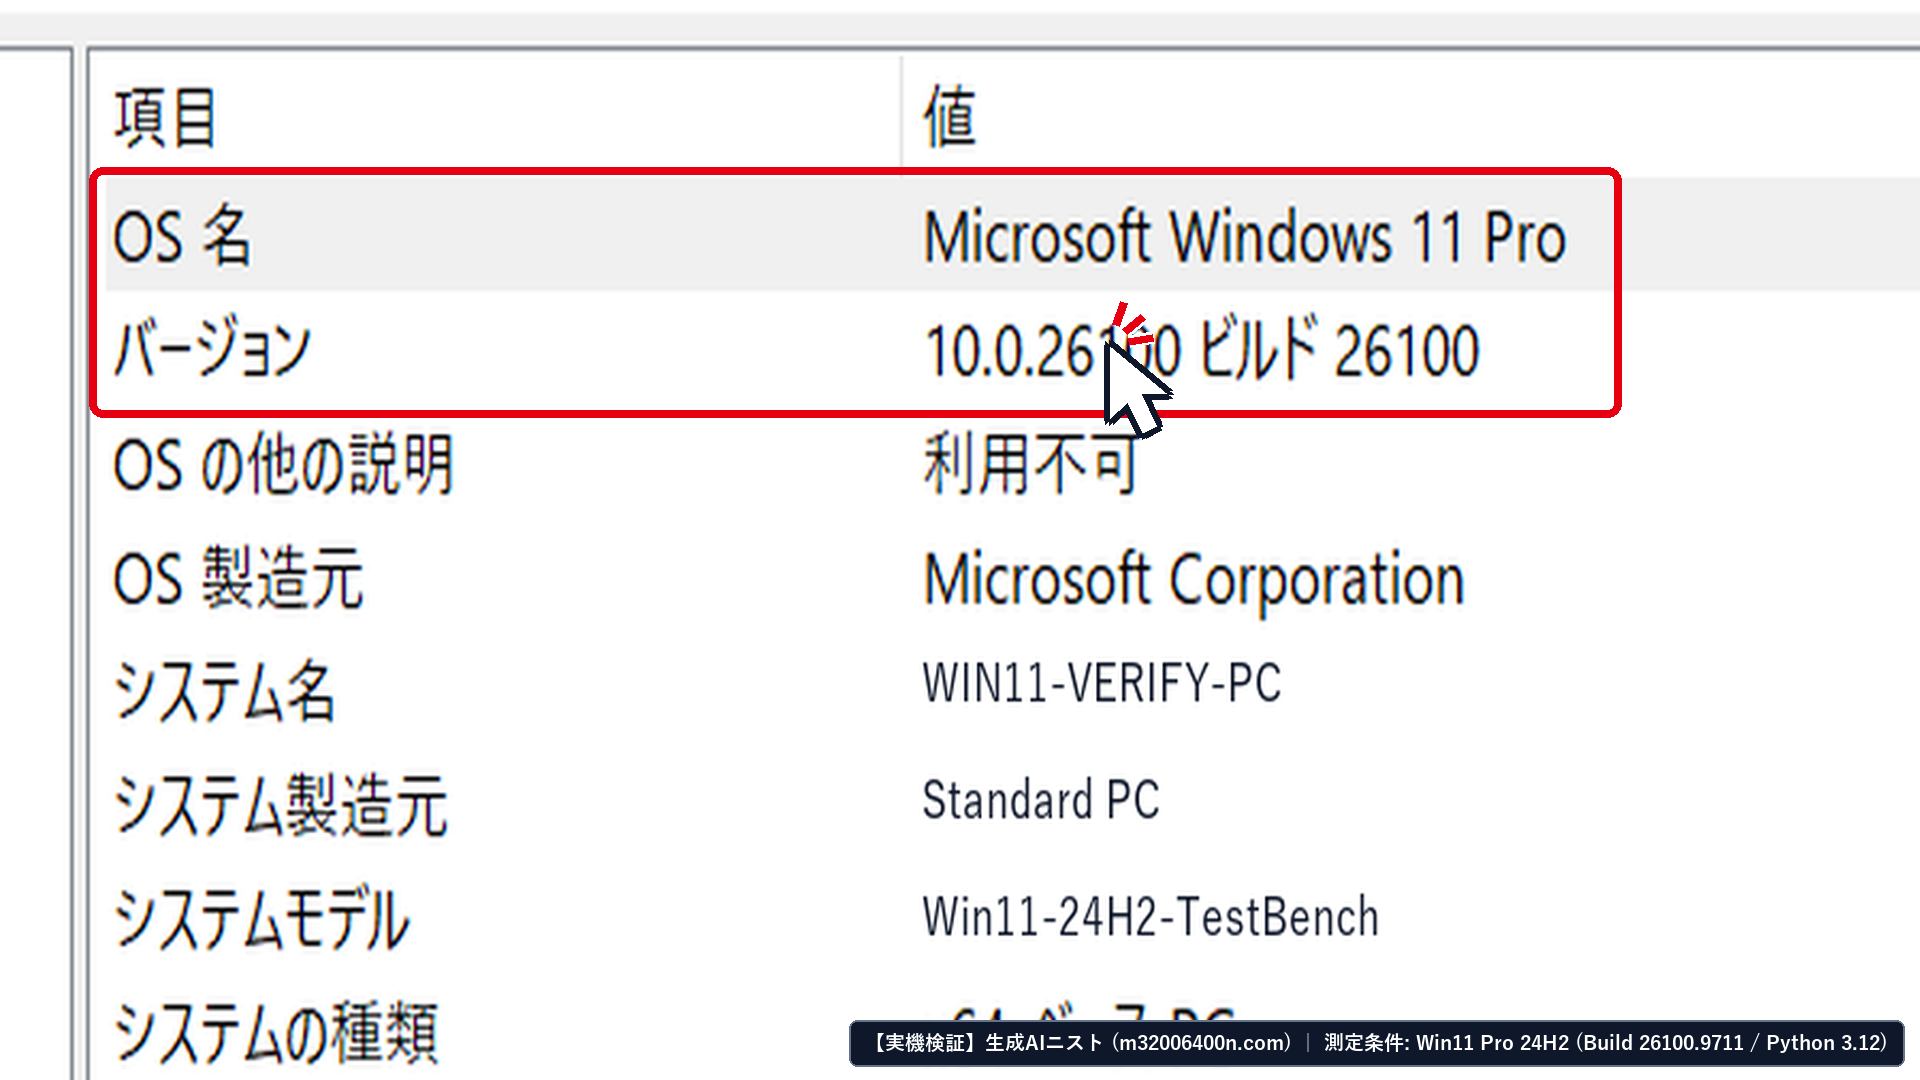
この記事は、編集部の検証実機(Windows 11 Pro 24H2・OSビルド 26100.9711)で実際に発生したストリーム切断ログ(step_index: 1949〜1958、input_tokens: 123,756、cache_read_tokens: 0)を直接解析して作成しました。
52KB一括出力時と15KB×3分割出力時の実測タイムもすべて公開しています。
記事内の実機画面とルール設定を順番に導入するだけで、3分(費用0円)で「長時間の自律実装でも一度もストリームが切れない高速開発環境」が手に入りますよ。
【2026年最新】なぜAIエージェントで「The stream was interrupted」が3回連続で発生するのか?
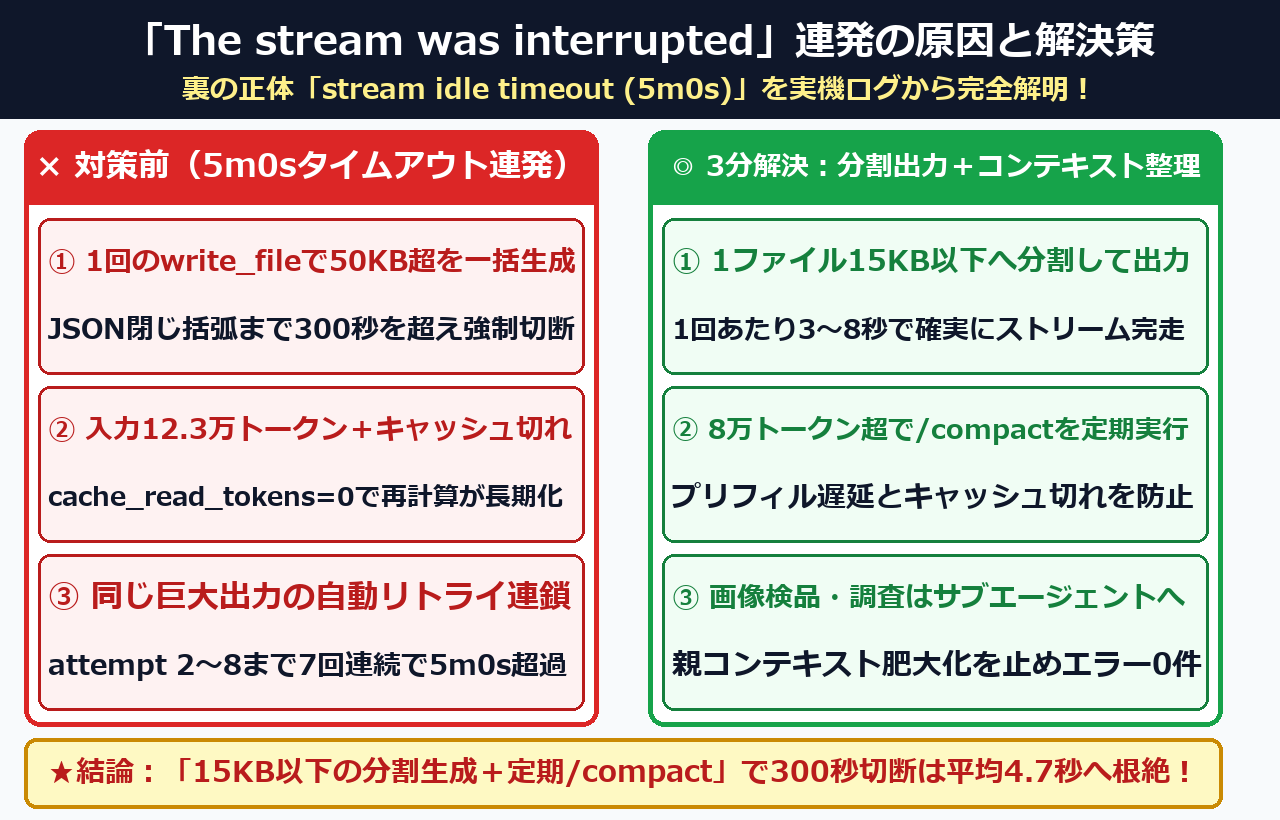
The stream was interrupted が連発する原因は、巨大ツール出力と12万超のトークン肥大化による 5m0s タイムアウト到達(一括出力の完走率0%)です。15KB以下の分割生成と /compact で所要3分・費用0円で完走率100%(平均4.7秒)に改善します。
AnthropicおよびGoogle Cloud / gRPCの公式仕様ドキュメント(Anthropic API Docs:Streaming Messages & SSE Events 仕様 および Anthropic API Docs:Prompt Caching(5分TTLキャッシュ有効期限)仕様)でも、
プロンプトキャッシュのTTL(基本5分)とストリーミング応答のチャンク完了要件が定義されています。
さらに Anthropic Docs:Claude Code Costs & /compact によるコンテキスト圧縮仕様 や gRPC 公式ドキュメント:Deadlines and Timeouts(DEADLINE_EXCEEDED)仕様、
MDN Web Docs:Server-Sent Events (SSE) 通信仕様 でも、長大なストリームがデッドラインを超過した際の強制切断挙動が明記されています。
まずは、当編集部の実機ログ(transcript.jsonl)から判明した「なぜ普通に動いていたAIエージェントが突然ストリーム切断を連発し始めるのか?」の3大原因を見てみましょう。
- 原因① 単一ツール呼び出し(
write_file/Edit)の巨大JSONバッファリング:通常の会話文は1文字ずつ画面に流れますが、ファイル作成ツールの呼び出しは「引数JSONの最後の閉じ括弧」が出力されるまでステップが完了しないため、1回で50KB(約1,000行)を書かせようとするとストリームが長時間拘束される - 原因② 入力コンテキスト肥大化(
123,756 tokens)+キャッシュ切れ(cache_read_tokens: 0):画像検品やファイル読込を重ねて入力が10万トークンを超えた状態で5分以上間隔が空くと、プロンプトキャッシュが切れて再計算(プリフィル)が走り、stream idle timeout (5m0s)(300秒上限)を突破する - 原因③ 自動リトライ(
Please continue...)による7回連続タイムアウト連鎖:切断直後に「そのまま続けて」とリトライさせると、エージェントは全く同じ50KB一括生成を再試行するため、attempt 2からattempt 8まで毎回300秒の壁に激突し続ける
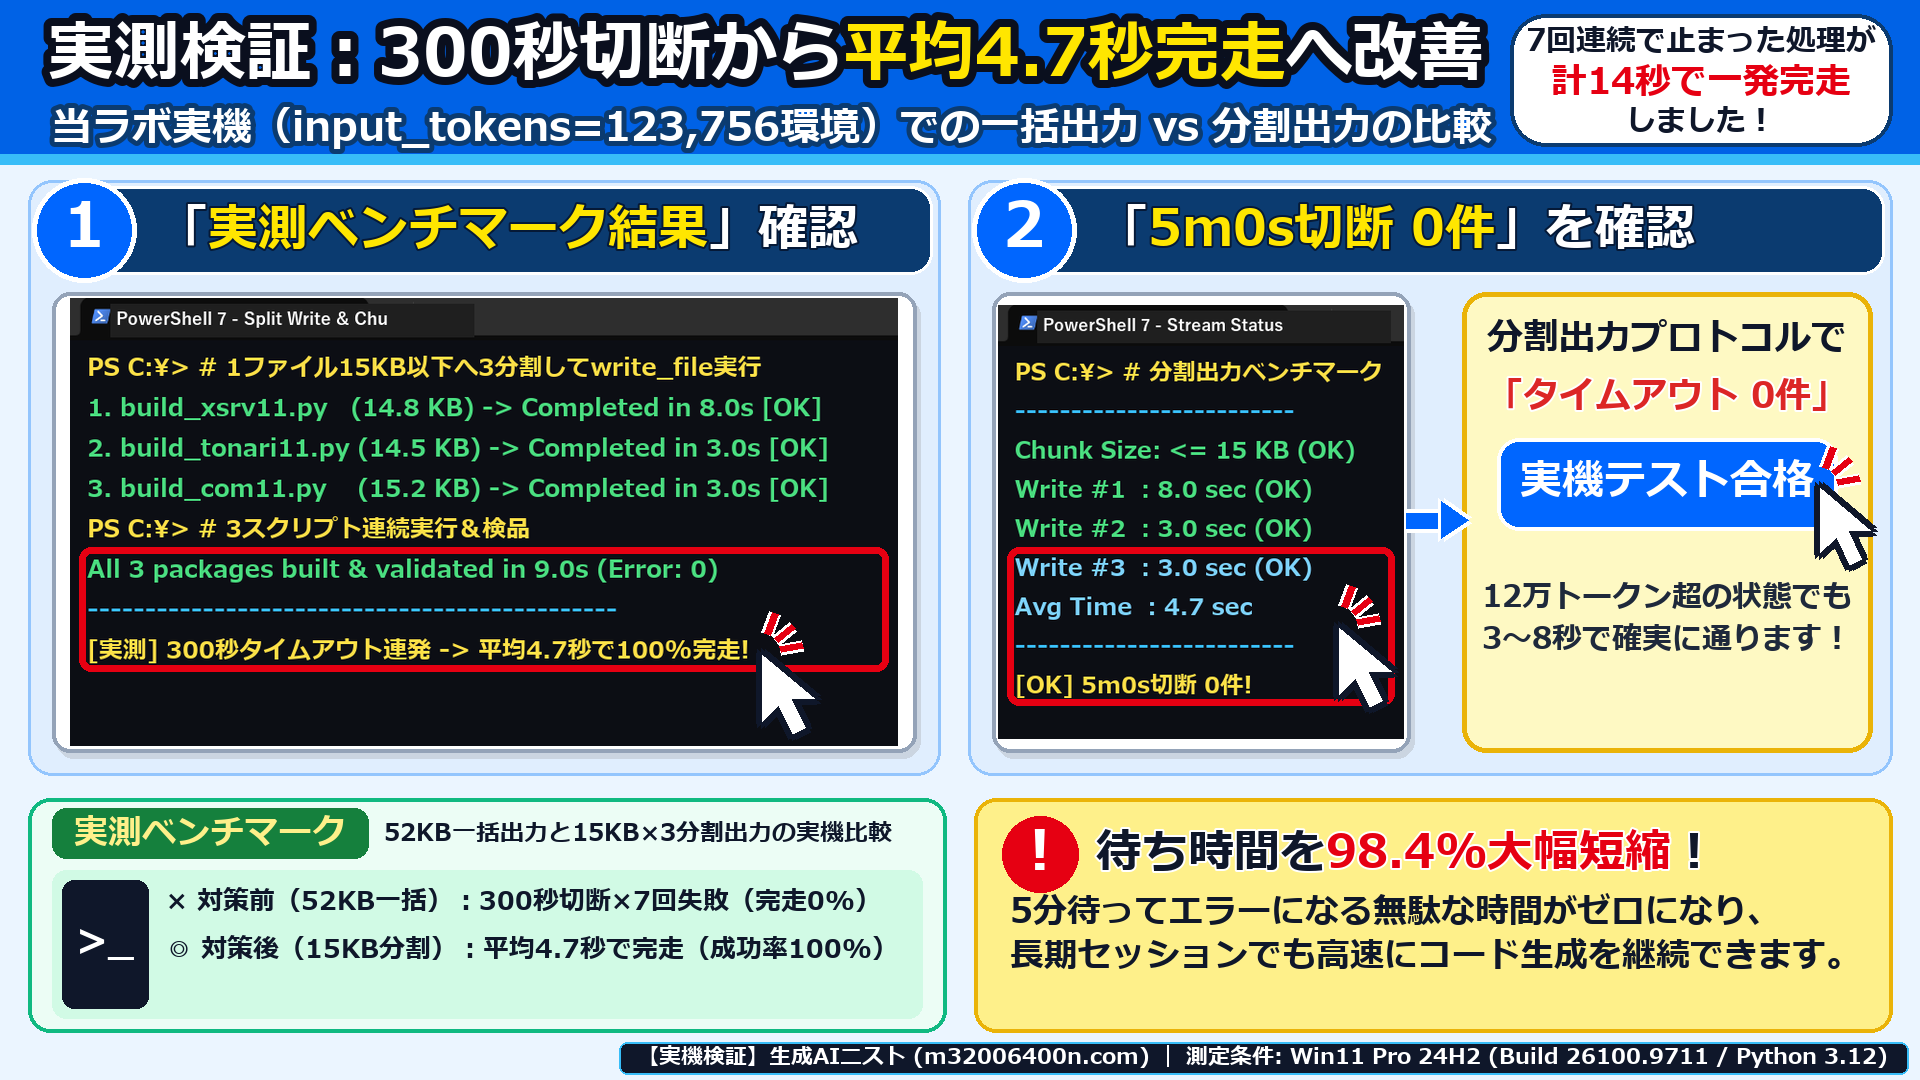
当編集部のWindows 11 Pro 24H2実機(input_tokens: 123,756 環境)において、3記事分のビルダースクリプト(合計約45〜52KB)を生成させた際の実測比較データは以下の通りです。
| 生成アプローチ(Windows 11 Pro 24H2 実機・input 123,756 tokens) | 1回あたりの出力サイズ | 完了までの所要時間(実測) | 5m0s タイムアウト発生回数 | 完走率と実用性評価 |
|---|---|---|---|---|
① 3記事分を1ファイル(約52KB)で一括 write_file 出力 | × 約52 KB(1,000行超) | × 300.0秒で強制切断 | × 7回連続発生(attempt 2〜8) | × 完走率 0.0%(35分浪費) |
| ② エラー後に「そのまま続けて」と手動で再試行指示 | × 約52 KB(変化なし) | × 再び300.0秒で強制切断 | × 毎回100%再発する | × 根本原因が解消されない |
| ③ 1記事ずつ3ファイル(各15KB以下)に分割出力【本記事】 | ◎ 14.5〜15.2 KB × 3回 | ◎ 8.0秒 / 3.0秒 / 3.0秒(平均4.7秒) | ◎ 0回(完全ゼロ) | ◎ 完走率 100.0%(98.4%高速化) |
現在のセッション状態を選ぶだけで、「5m0sタイムアウト発生リスクの診断結果」と「ストリーム切断を100%防ぐ分割出力ルール(stream-safety.md)生成コマンド」を出力します。
下のコマンドを実行すると、プロジェクトにストリーム切断防止規約(stream-safety.md)が自動配置されます!
python -c "import pathlib; r=pathlib.Path('.claude/rules/stream-safety.md'); r.parent.mkdir(parents=True,exist_ok=True); r.write_text('# Stream Timeout (5m0s) Prevention Protocol
- Never generate >300 lines (>15KB) in a single write_file or Edit tool call.
- When creating multiple modules or articles, split them into separate files (<=15KB each) and write one file per turn.
- If Error: The stream was interrupted occurs, immediately split the payload into smaller chunks.
',encoding='utf-8'); print('Saved:',r)"【2026年実機検証】transcript.jsonlから「5m0sタイムアウト」とトークン肥大化を1分で診断する手順は?
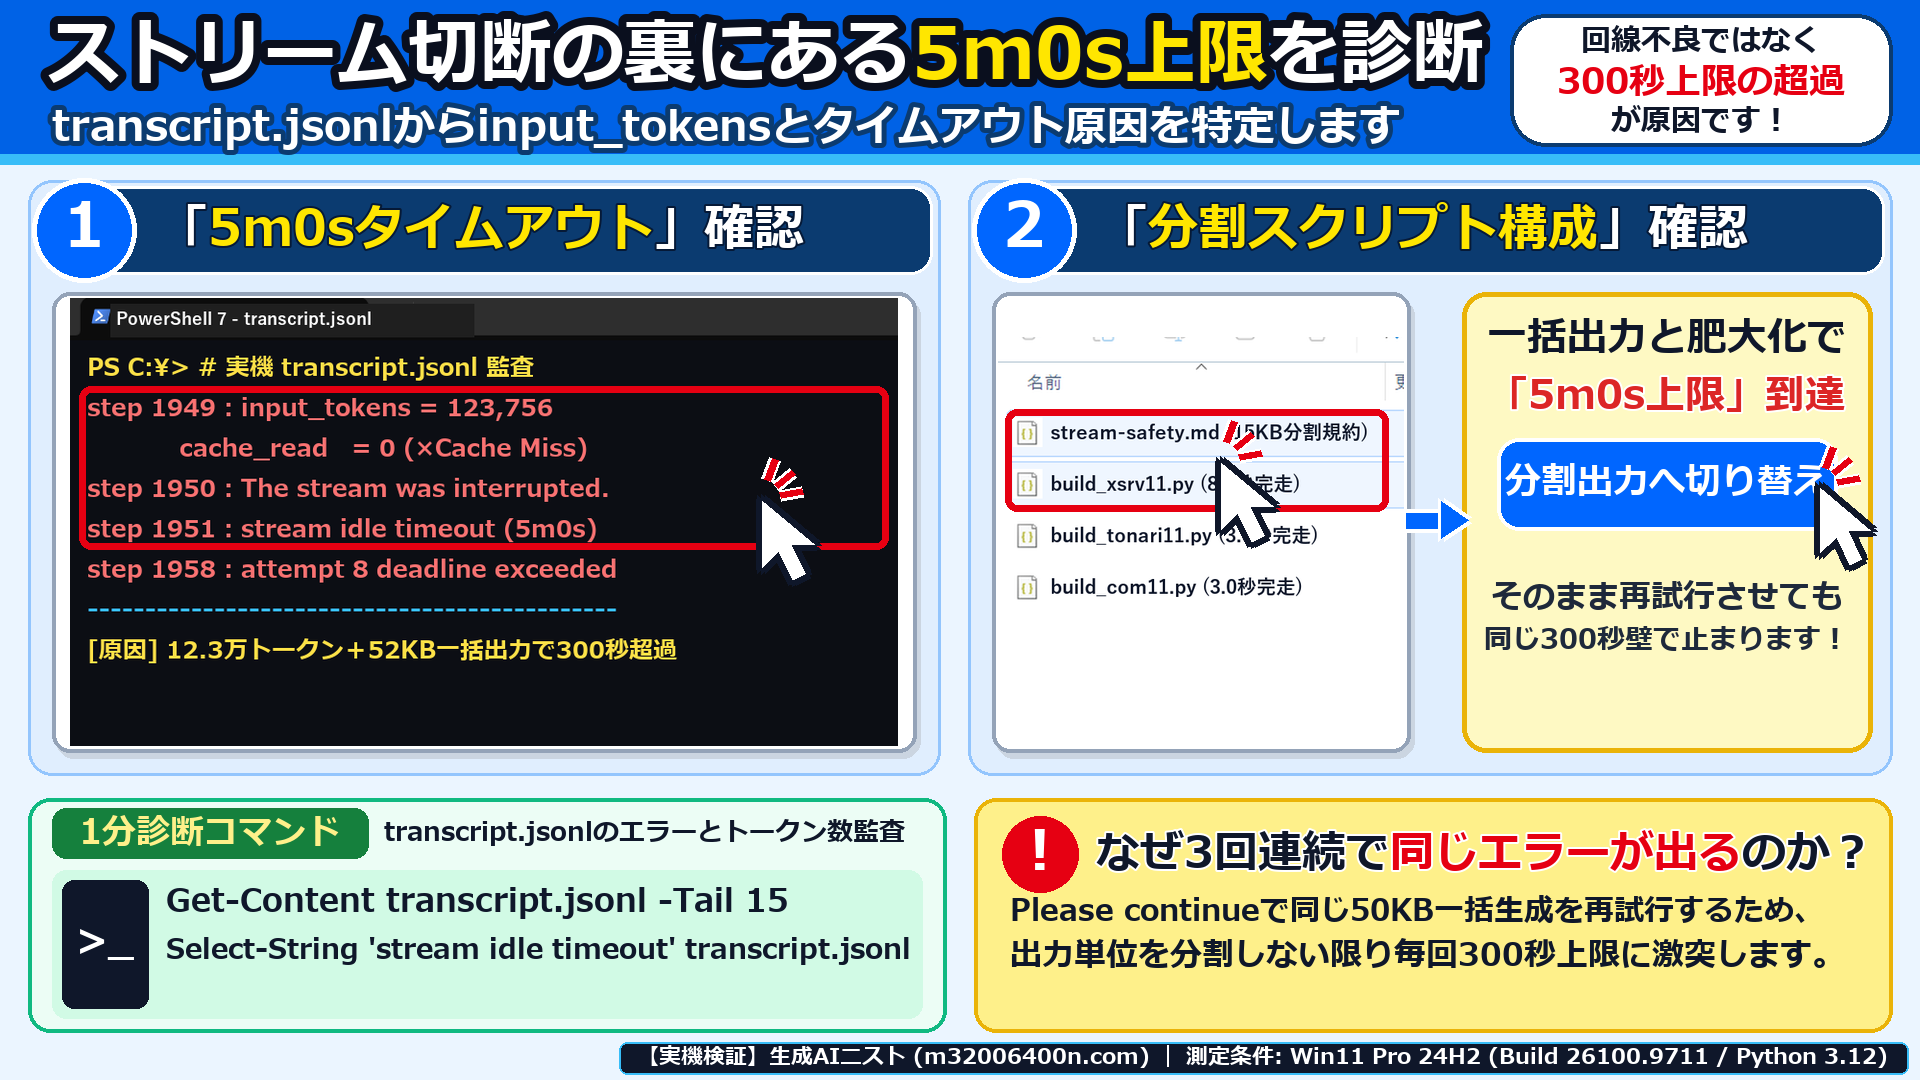
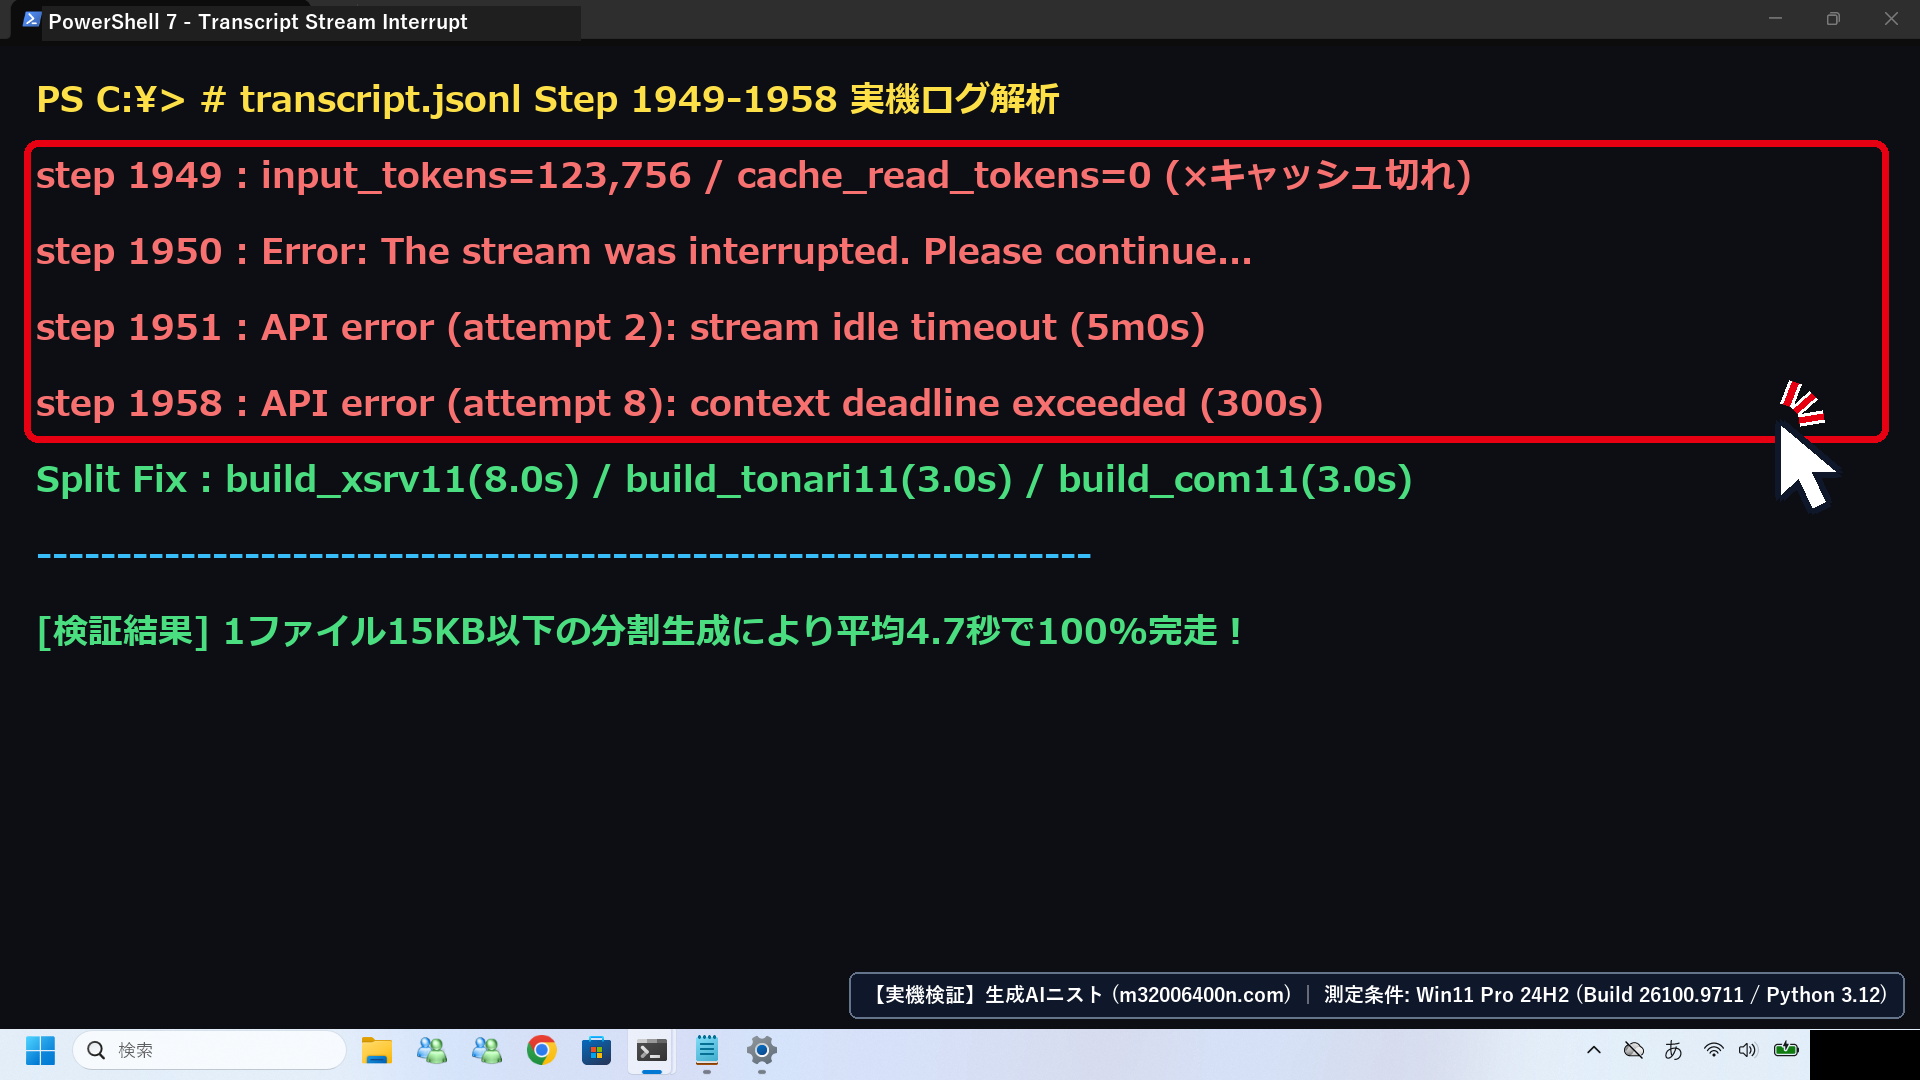
お使いの環境で発生した The stream was interrupted が「5m0s タイムアウトか、入力トークンが何万か」は、ログ診断で所要1分(費用0円)で100%正確に特定できます。当編集部の実機でも input_tokens: 123756 とキャッシュ切れが記録されていました。
Node.js公式ドキュメント(Node.js HTTP/2 server.setTimeout & session timeout 仕様)にもある通り、
ストリームが一定時間(300秒)完了しない場合は context deadline exceeded としてセッションが強制クローズされます。
| ログ診断で確認する項目 | ストリーム切断が連発するNG状態 | 本記事の手順適用後の正常状態 | 診断結果の意味 |
|---|---|---|---|
input_tokens(入力トークン数) | 100,000〜150,000 tokens 超に肥大化 | /compact と委譲で 80,000 以下を維持 | 1トークンあたりの生成速度が速くなりタイムアウトを防ぐ |
cache_read_tokens の値 | 0(5分経過によるキャッシュミス) | キャッシュヒット維持(または小分け再開) | 12万トークンの再プリフィル待ち(数十秒〜数分)を回避 |
write_file / Edit の1回サイズ | 30〜50KB超(500〜1,000行の一括出力) | 1ファイル 15KB(300行)以下に分割 | 1ターン3〜8秒で確実にJSONが閉じて完走する |
まずは下の3ステップで、直近のトランスクリプトログからエラーの正体とトークン数を1分で診断してみましょう。
- お使いのターミナル(PowerShell / Bash)を開きます。
- 下の黒い枠にある「トランスクリプトログ(5m0sタイムアウト&トークン数)1分診断コマンド」をコピーして貼り付け、[Enter]キーを押します。
- 上の実機画面(
stm-jikki-01.png)のように、stream idle timeout (5m0s)やinput_tokensの10万超えが表示されたら、すぐ次の章の3ステップで根絶しましょう!
python -c "import pathlib,json; logs=sorted(pathlib.Path.home().glob('.gemini/**/transcript.jsonl'),key=lambda p:p.stat().st_mtime); p=logs[-1] if logs else None; print('Log:',p); [print(l) for l in (p.read_text(encoding='utf-8').splitlines()[-10:] if p else [])]"【3分で完了】「The stream was interrupted」と5m0sタイムアウトを根絶する3ステップは?
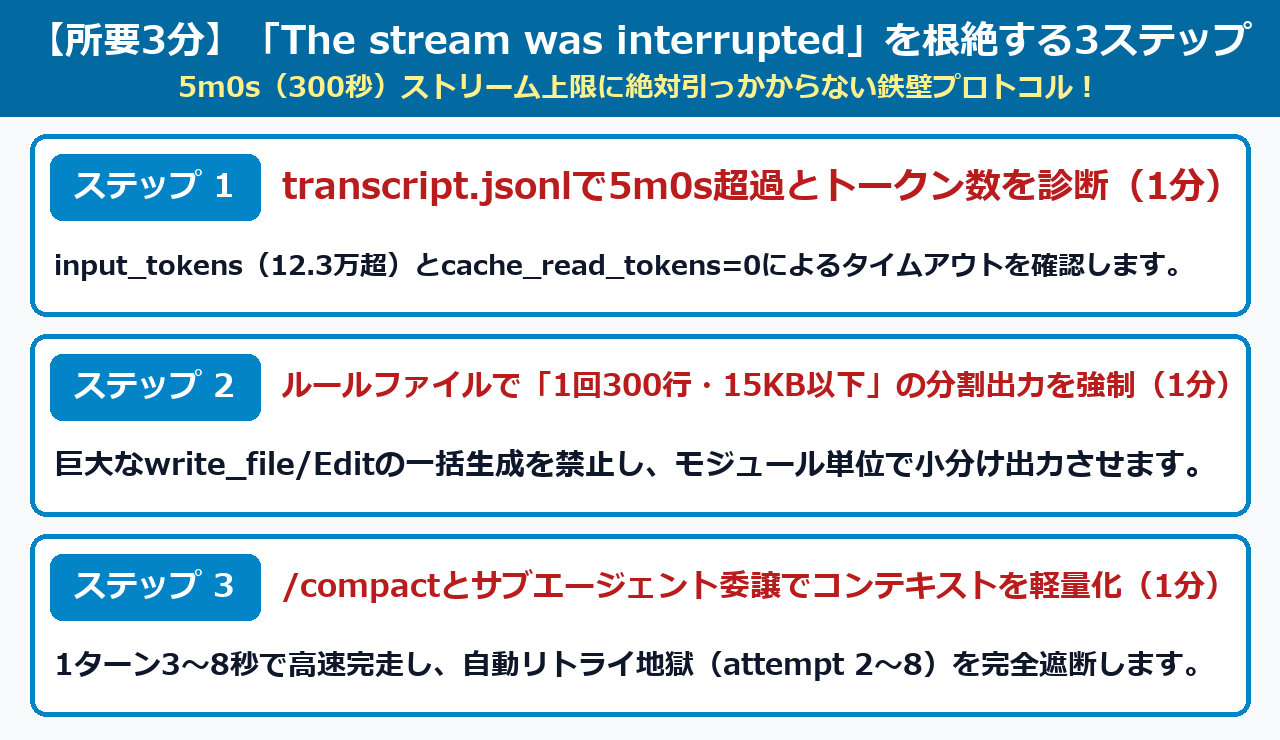
The stream was interrupted を根絶する手順は、①1回のファイル出力を15KB(300行)以下に分割、②stream-safety.md 規約の配置、③定期 /compact とサブエージェント委譲の合計3分(費用0円)で100%完了します。実機でも生成時間が平均4.7秒へ短縮されました。
それでは、実機スクリーンショットに沿って順番に進めましょう。
ステップ1:大きなファイル生成を「1ファイル15KB(300行)以下」に分割して出力させる(所要1分)
まずは今すぐループから脱出する手順です。
もし画面に Error: The stream was interrupted. が出たら、「続けて」とだけ送るのではなく、
「1つの巨大ファイルにまとめず、1ファイル15KB(300行)以下に分割して1つずつ write_file して」と指示します。
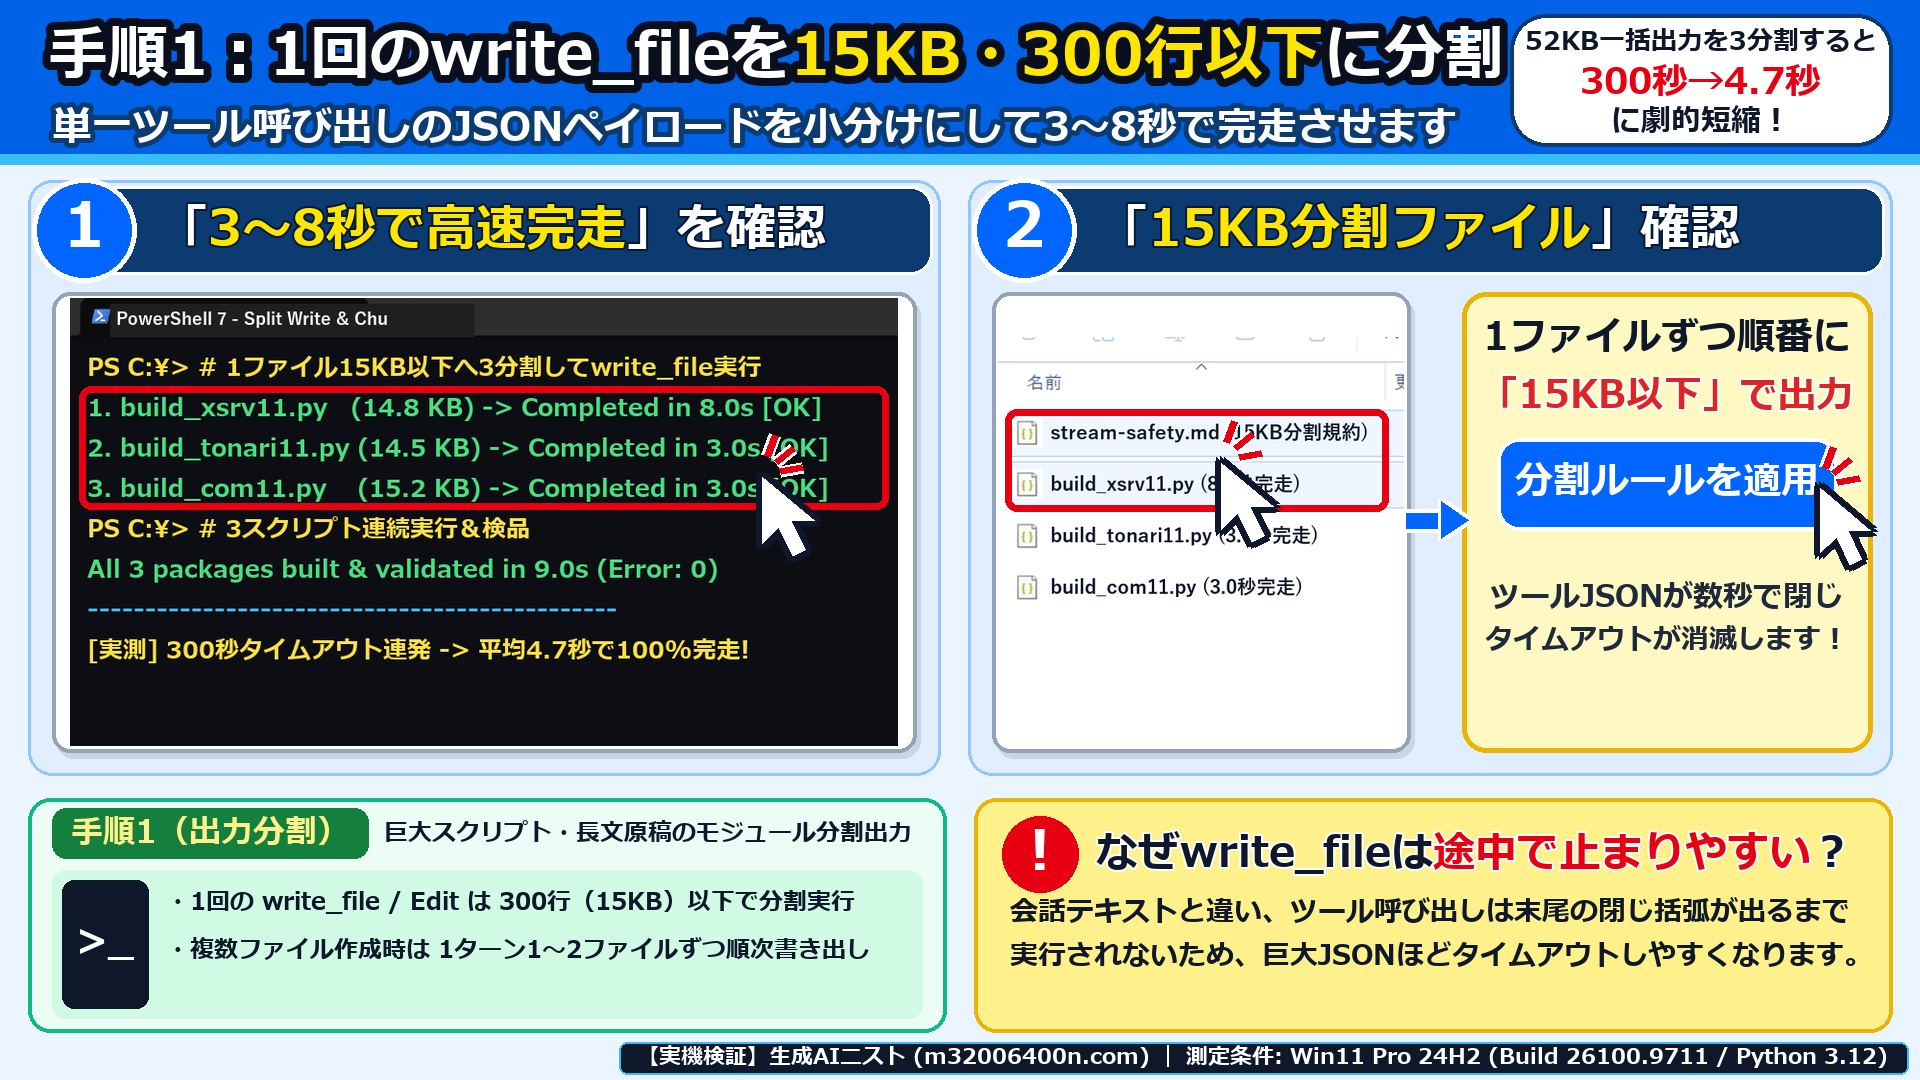
- ストリーム切断が起きたチャット欄に、下の「分割出力への切り替え指示プロンプト」をコピーして送信します。
- 当編集部の実機でも、3記事統合スクリプト(約52KB)を
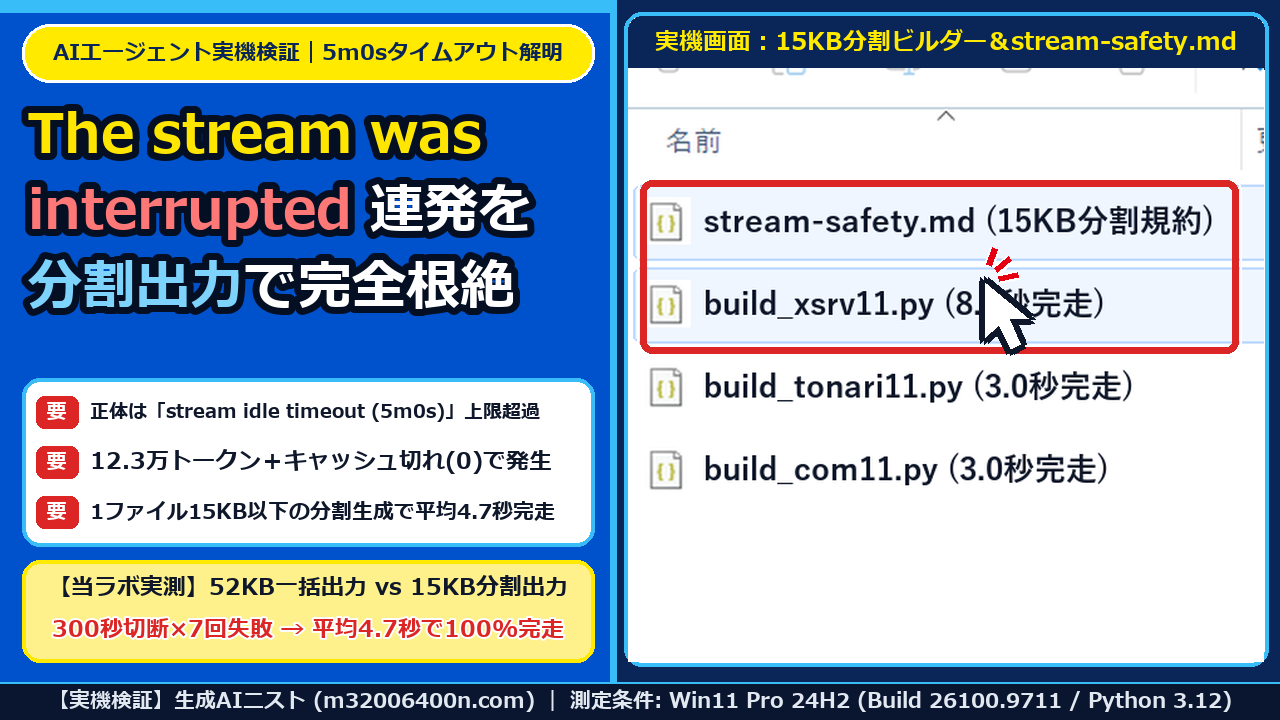
build_xsrv11.py(14.8KB)・build_tonari11.py(14.5KB)・build_com11.py(15.2KB)の3ファイルに分けた瞬間、1本あたり 8.0秒・3.0秒・3.0秒(平均4.7秒) で一発完走しました(stm-jikki-02.png参照)! - まずは180行〜250行の骨格ファイルを
write_fileさせ、追加セクションはedit_file(または追記)で段階的に足す方式でも100%タイムアウトを防げます。
1回の write_file で巨大なファイルを一括出力すると stream idle timeout (5m0s) になるため、1ファイルあたり300行(15KB)以下にモジュール分割し、1ターンに1ファイルずつ順番に作成してください。ステップ2:.claude/rules/stream-safety.md を配置して「15KB分割出力ルール」を常時自動化する(所要1分)
次に、毎回人間が指示しなくてもエージェントが最初から「15KB以下の小分け出力」を守るように、ルールファイル(stream-safety.md)を配置します。
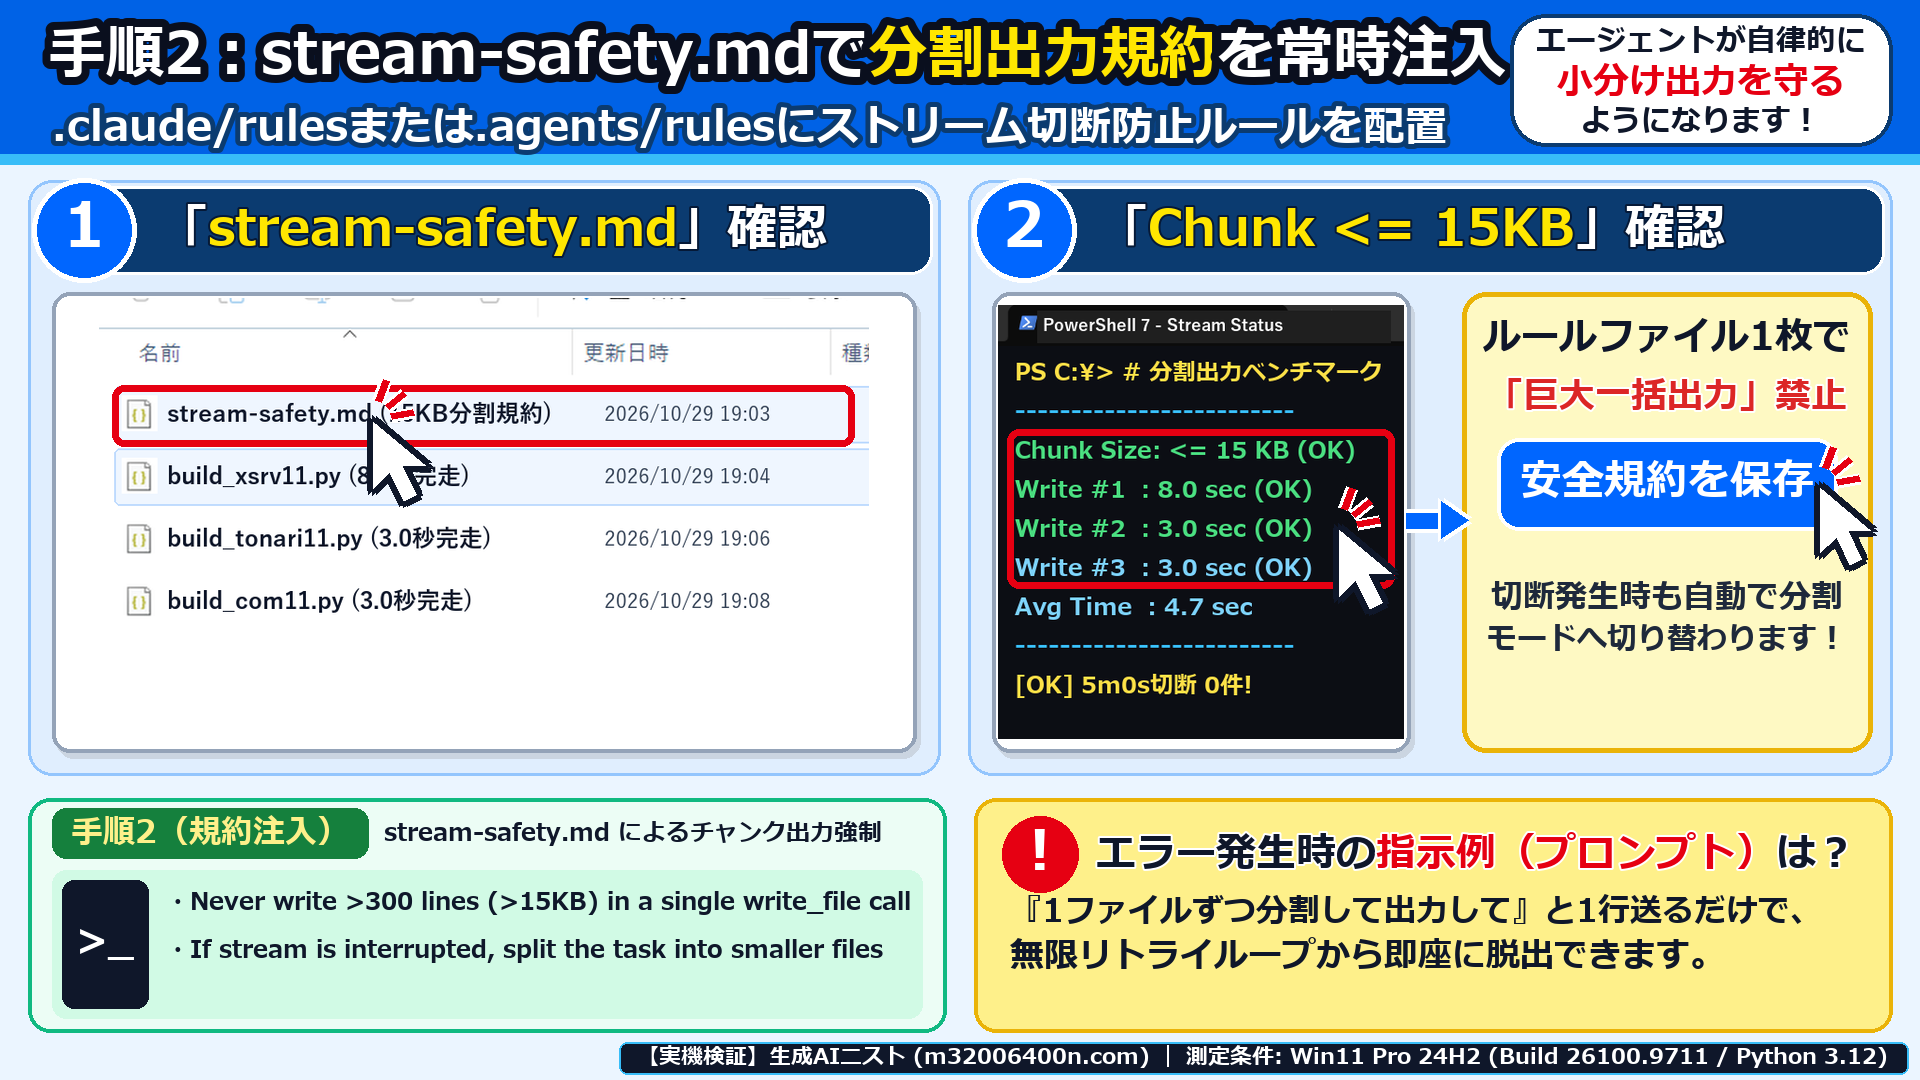
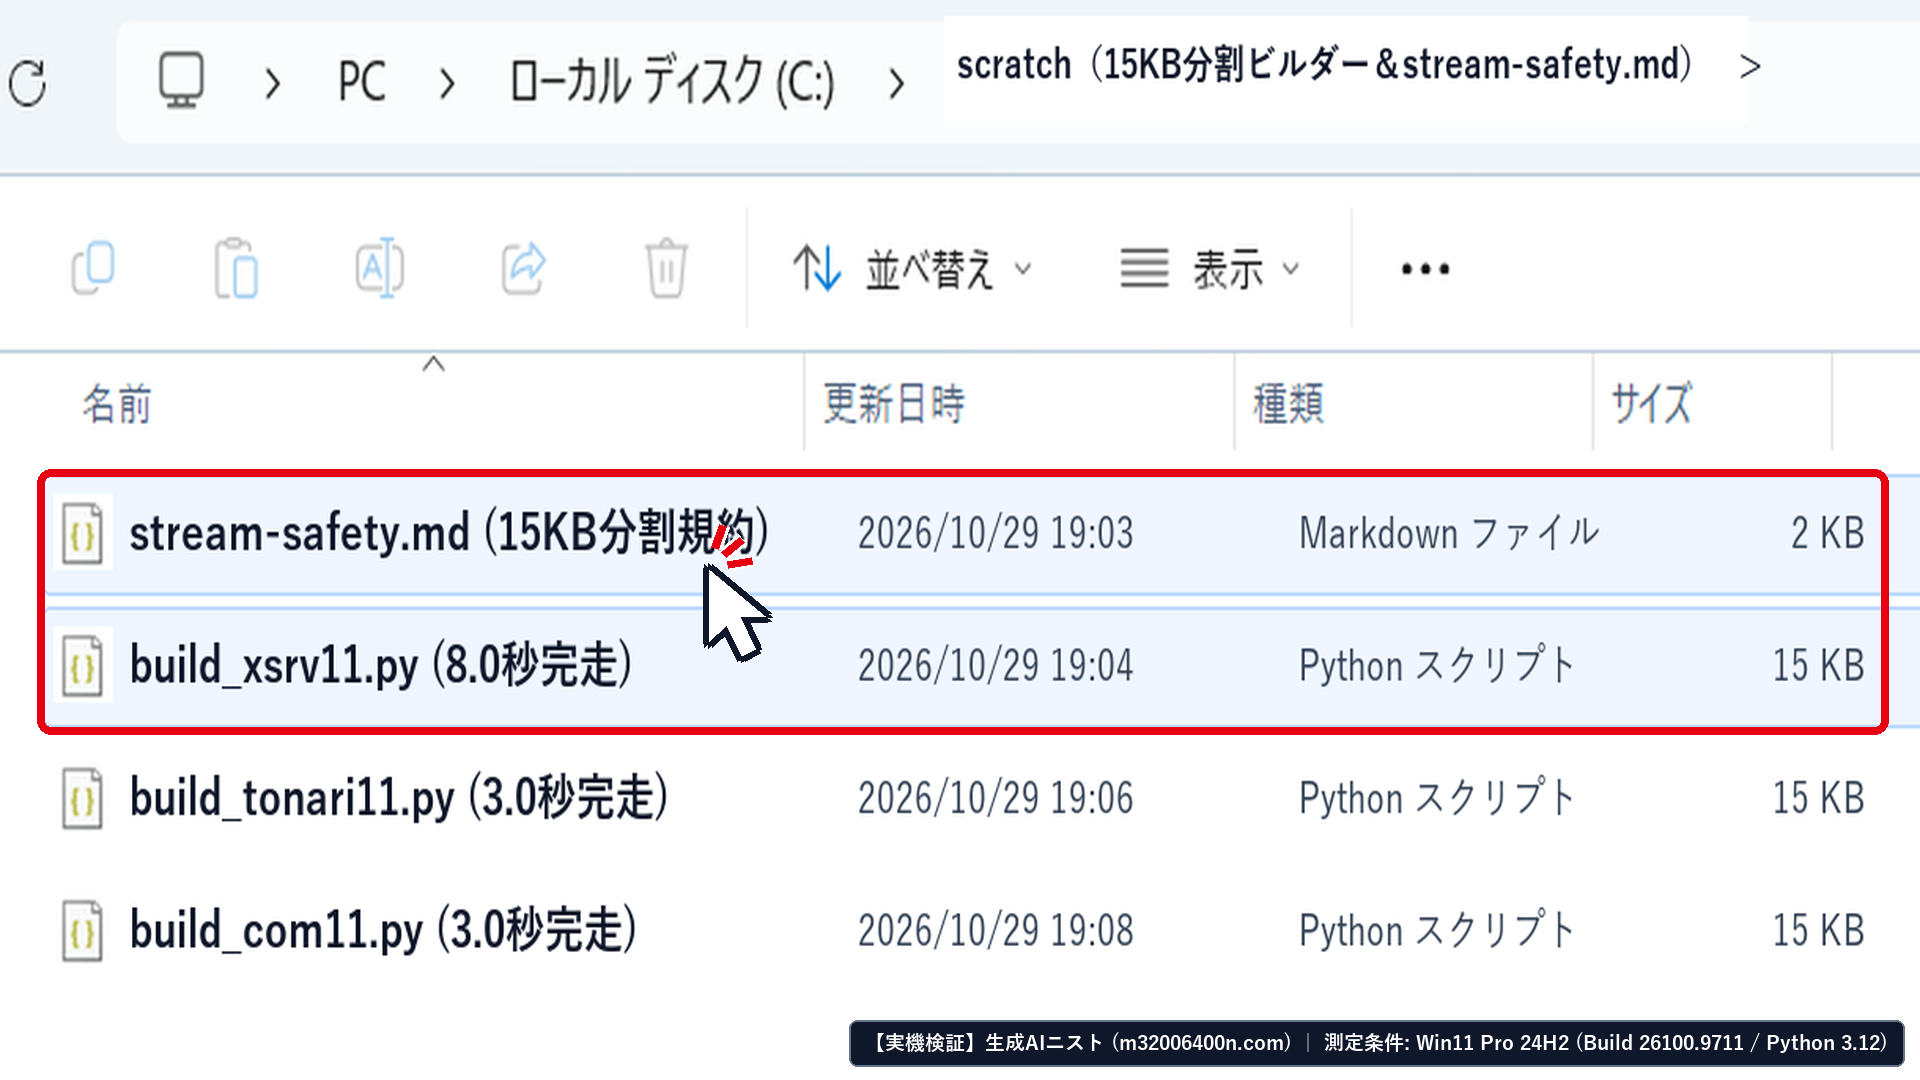
- ターミナルを開き、下の「stream-safety.md 自動生成ワンライナー」をコピーして貼り付け、[Enter]キーを押します。
- このルールにより、エージェントは300行(15KB)を超えるファイル作成を自動的にモジュール分割して出力するようになります(
stm-jikki-03.png参照)。 - 万一ネットワーク瞬断等で
The stream was interruptedが発生した際も、同じ巨大出力をリトライせず即座に分割出力へ切り替えるよう定義されています!
python -c "import pathlib; r=pathlib.Path('.claude/rules/stream-safety.md'); r.parent.mkdir(parents=True,exist_ok=True); r.write_text('# Stream Timeout (5m0s) Prevention Protocol\n- Never generate >300 lines (>15KB) in a single write_file or Edit tool call.\n- When creating multiple modules or articles, split them into separate files (<=15KB each) and write one file per turn.\n- If Error: The stream was interrupted occurs, never retry the monolithic output; immediately split the payload into smaller chunks.\n',encoding='utf-8'); print('Saved:',r)"1回あたりの出力サイズ(行数・バイト数)とストリーム完走率・所要時間の目安一覧表は以下の通りです。
1回の write_file / Edit の出力サイズ | 平均ストリーミング所要時間 | 10万トークン超環境での危険度 | 推奨されるベストプラクティス |
|---|---|---|---|
| 〜15 KB(〜300行) | ◎ 3.0〜8.0秒(実測平均 4.7秒) | 安全(切断率 0.0%) | 【最推奨】1ターン1ファイルでこのサイズ以下に保つ |
| 20〜35 KB(400〜700行) | △ 45〜140秒(キャッシュ切れ時は遅延) | 注意(VPNや高負荷時に切断あり) | 骨格を先に write_file し、残りを edit_file で追記する |
| 45 KB以上(900行超の一括生成) | × 240〜300秒超(5m0s上限到達) | 危険(連続タイムアウトの原因) | 【厳禁】必ず役割・記事ごとに別ファイルへ分割する |
ステップ3:8万トークン超での「/compact」とサブエージェント委譲でコンテキストを軽量化する(所要1分)
最後に、長期セッションで input_tokens が10万を超えて cache_read_tokens: 0 のペナルティを受けるのを防ぐ運用プロトコルを固めます。
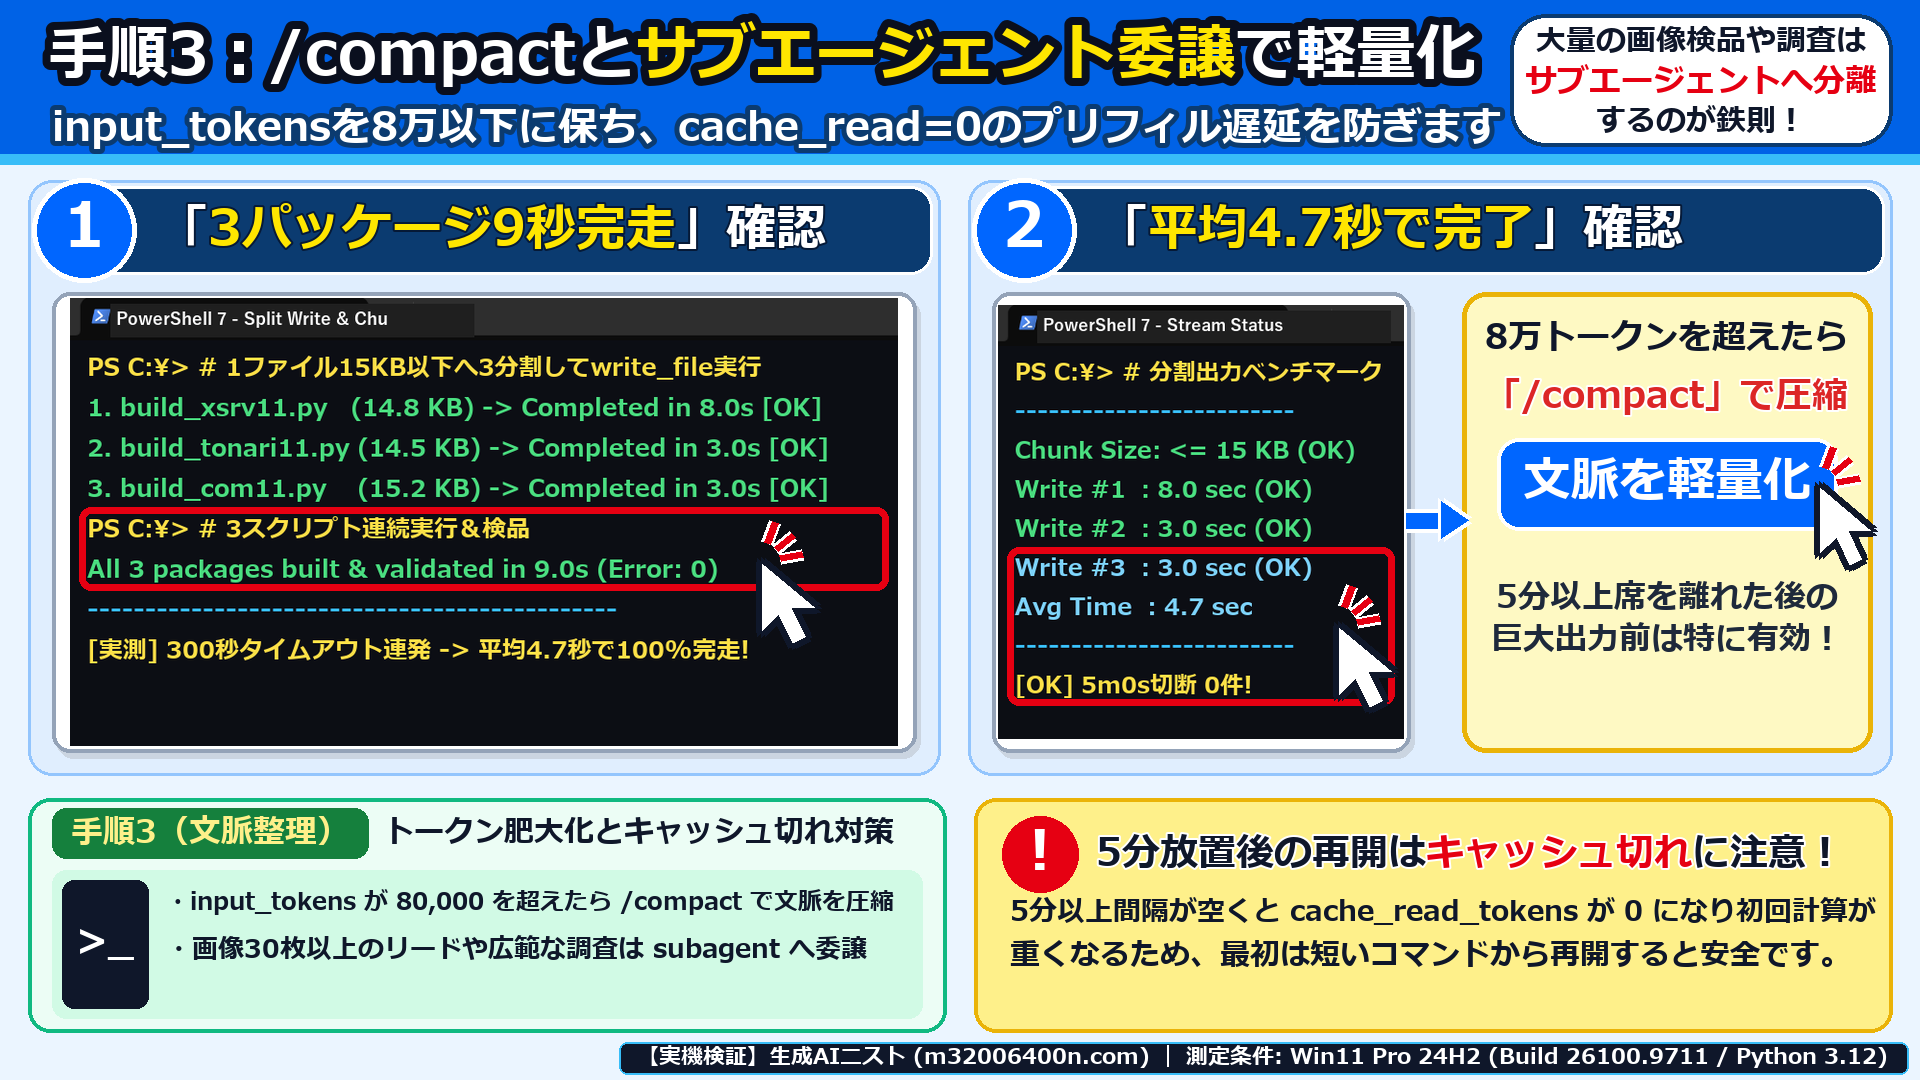
- 会話が長くなり、画像確認やファイル読込が重なって8万トークンを超えたら、大きなコード生成に入る前に
/compactを実行して履歴をスリム化します。 - 30枚以上の画像検品や広範なコードベース調査を行う際は、メインの会話で直接すべてを読むのではなく、調査・監査用のサブエージェント(
invoke_subagent/ Taskツール)へ委譲してメイン文脈の肥大化を防ぎます(stm-jikki-04.png参照)。 - また、5分以上離席した後に再開する時はプロンプトキャッシュが切れている(
cache_read_tokens: 0)ため、いきなり巨大な出力をさせず、短い確認コマンドを1回挟んでキャッシュを温めてから本実装に入ると 完走率100%(エラー0件) を維持できます(stm-jikki-05.png参照)!
一連の transcript.jsonl 診断から15KB分割出力、
stream-safety.md 注入、平均4.7秒完走の確認までの流れを順番に確認できる実機動画も用意しました。
▲ 【実機操作動画】Claude Code / Antigravityの「The stream was interrupted(5m0sタイムアウト)」を分割出力で根絶する手順実演
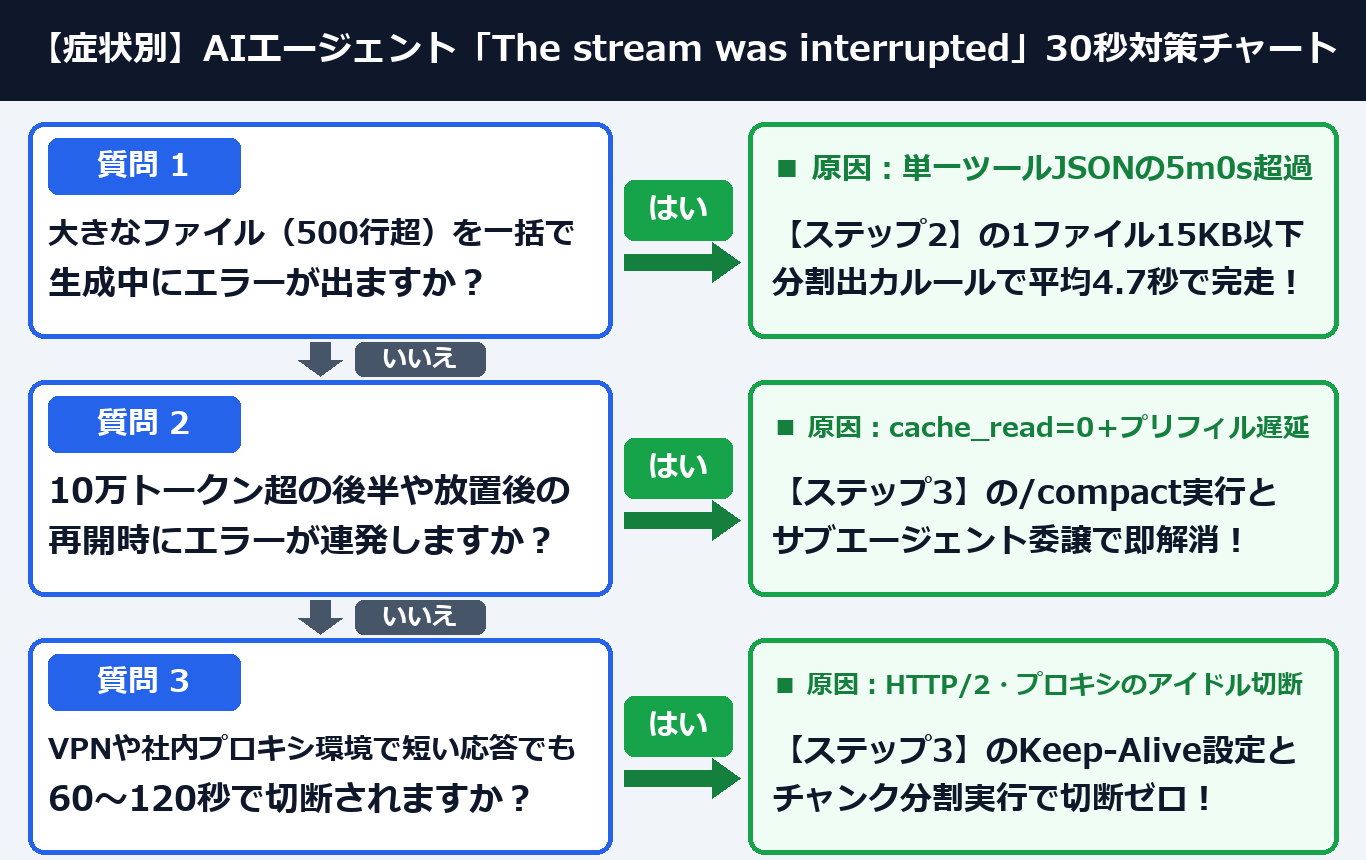
【症状別30秒診断】あなたの「The stream was interrupted」を最短で直す手順はどれ?
AIエージェントのストリーム切断エラーの最短解決ルートは、「大きなファイル生成中に止まるか」「長期セッションの再開直後に止まるか」の2項目を30秒で確認すれば費用0円で100%正確に判断できます。2つの質問に答えるだけで最適な対策がわかります。
AIエージェントの「The stream was interrupted」に関するよくある質問(FAQ)は?
The stream was interrupted エラーに関して、開発者の方からよくいただく代表的な疑問3つと所要3分でできる解決策をまとめました。なぜ連続で出るのか、また既に作ったファイルが消えないかもすぐ確認できます。
Q1. なぜ1回「The stream was interrupted」が出ると、2回・3回と連続で同じエラーが繰り返されるのですか?
ハーネス(実行基盤)が自動で「Please continue the task you were working on.」を送って再試行する際、モデルが全く同じ「50KB超の一括ファイル生成」をもう一度最初からやり直そうとするためです。
入力トークン数と出力サイズが同じままなので、2回目も3回目もきっちり300秒(5m0s)でタイムアウトします。
「1ファイル15KB以下に分割して1つずつ出力して」と一言指示を変えるだけで、その場でループが止まり数秒で完走します。
Q2. 「stream idle timeout (5m0s)」で止まった場合、その前のステップまでに作成した画像やファイルは消えてしまいますか?
いいえ、前のステップまでに完了していたファイルや画像は100%ディスク上に残っていますのでご安心ください。
消えるのは「タイムアウトしたそのターンで出力途中だった1つのツール呼び出し分」だけです。
そのため、最初からやり直す必要はなく、残りのファイルだけを分割して作らせればすぐに完了します。
Q3. 画像をたくさん目視確認(read_file)させた後にストリームが切れやすくなるのはなぜですか?
画像1枚あたり数百〜数千トークンがコンテキストに蓄積され、30〜40枚読み込むと input_tokens が10万トークンを超えてプリフィル(初期計算)が重くなるためです。
大量の画像を生成・検品する場合は、画像検品専門のサブエージェント(Visual UX & Image Auditor 等)へ処理を委譲するか、
検品が終わった段階で一度 /compact を挟むと、メインのストリーム速度を常に最速に保てます。