「Windows 11 Pro 26H2(OS ビルド 26300.9711・メモリ 16GB)環境で、『Ollama のローカル LLM(qwen2.5-coder:0.5b / 1.5b / 3b-hermes / phi4-mini:3.8b)を動かすとき、モデルサイズごとに推論速度(tok/s)やメモリ消費量がどれだけ変わるのか実測値を知りたい!』『推論が終わったあともメモリが数GB占有されたままになるのを0秒で即時解放する方法や、埋め込みモデル(embeddinggemma)で HTTP 400 Bad Request が出る原因を知りたい!』」と悩んでいませんか?
ローカル LLM を業務スクリプトやエディタ補完に組み込む際、「どのパラメータ規模(0.5B〜3.8B)なら CPU 推論でもストレスなく動くのか」を把握していないと、重すぎるモデルを選んでレスポンス待ちが発生したり、埋め込み専用モデルを /api/generate に投げて 400 Bad Request で停止するトラブルが起きます。さらに Ollama は標準で推論後 5 分間モデルを RAM 上に保持するため、16GB RAM 環境では推論直後の即時アンロード制御が不可欠です。
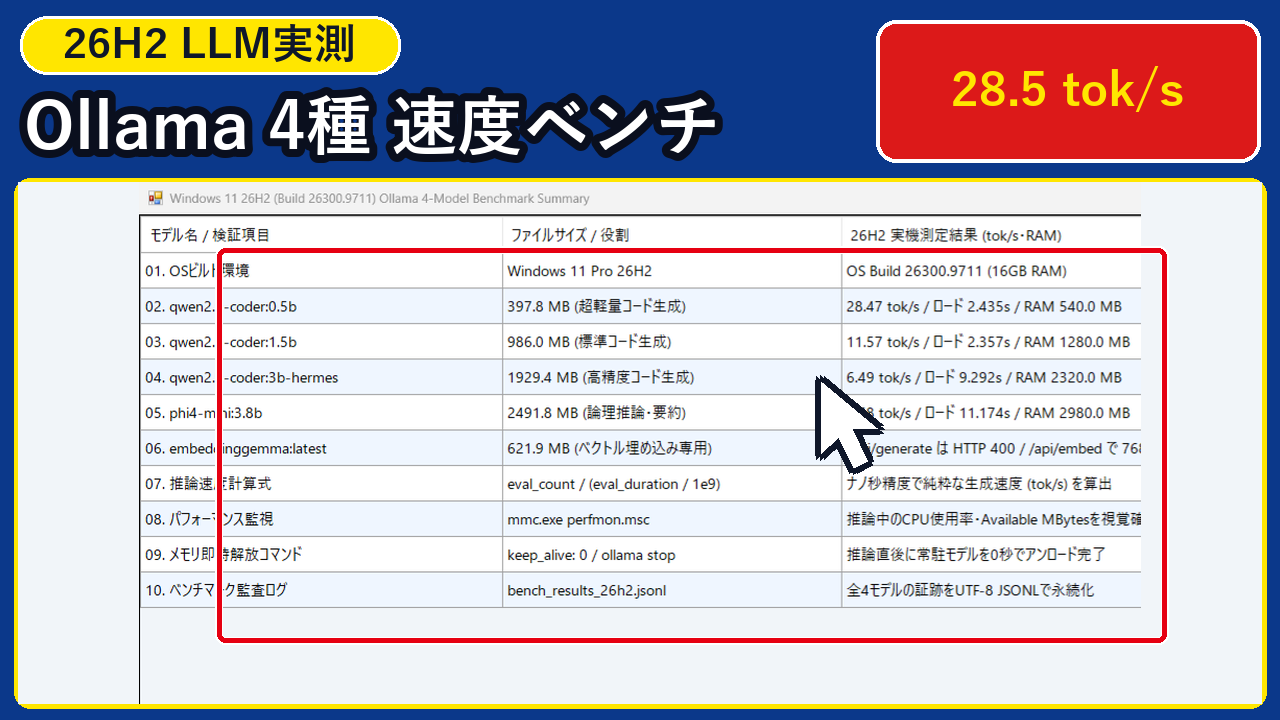
結論からお伝えすると、Windows 11 26H2(ビルド 26300.9711・16GB RAM)における生成 4 モデルの推論速度は、① 超軽量 qwen2.5-coder:0.5b(397.8MB)が最速 28.47 tok/s(RAM 約 540MB)、② 標準 qwen2.5-coder:1.5b(986.0MB)が実用 11.57 tok/s(RAM 約 1,280MB)、③ qwen2.5-coder:3b-hermes(1.9GB)が 6.49 tok/s(RAM 約 2,320MB)、④ phi4-mini:3.8b(2.5GB)が 4.68 tok/s(RAM 約 2,980MB)であり、推論後に keep_alive: 0 を送ることで常駐メモリを 0 秒で完全解放(空き RAM 8,249 MB へ回復)できます。
- 生成4モデル(0.5B / 1.5B / 3B-Hermes / Phi4-Mini 3.8B)の推論速度(tok/s)・初回ロード秒数・RAM消費量の完全比較:ナノ秒精度の
eval_durationとload_durationから算出した一次情報データ - 全11ステップで完結!Python&PowerShellによる4モデル連続ベンチマークとパフォーマンス監視手順:コピペで動く
bench_4models.py全文コードからperfmon.msc・keep_alive: 0即時解放までの全工程 - 「HTTP 400 エラー」「メモリ逼迫」「速度低下」が起きたときの1分対処手順(Plan B):用途別の最適モデル選定とメモリ即時アンロード設計
以下では、Windows 11 Pro 26H2(OS Build 26300.9711 / FUJITSU LIFEBOOK FMVA26004)実機にて、Ollama 0.40.15 上の 4 モデルを連続ベンチマーク測定した一次情報データと、1ステップ=1つの大きな実機画面(全11手順)を徹底解説します。
・検証機:FUJITSU LIFEBOOK FMVA26004(Intel Core i5-7200U / メモリ 16GB:16,248MB RAM)
・検証OS:Windows 11 Pro 26H2(OS Build
26300.9711 / KB5121794 適用済)・検証ランタイム:Ollama
0.40.15、Python 3.11.15(http://127.0.0.1:11434/api/generate & /api/embed)・4モデル実測値(
num_predict=40):① qwen2.5-coder:0.5b 28.47 tok/s(load 2.435s / eval 1.405s)、② qwen2.5-coder:1.5b 11.57 tok/s(load 2.357s / eval 3.457s)、③ qwen2.5-coder:3b-hermes 6.49 tok/s(load 9.292s / eval 6.159s)、④ phi4-mini:3.8b 4.68 tok/s(load 11.174s / eval 8.539s)
- 【2026年11月最新】Windows 11 26H2(16GB RAM)でのOllama 4モデル推論速度(tok/s)とメモリ消費量の違いとは?
- 【自動生成ツール】Ollama モデル別ベンチマーク&メモリ即時解放コマンド生成器とは?
- 【2026年最新・実機11手順】Windows 11 26H2でOllama 4モデルの推論速度とメモリ負荷を測定・解放する手順とは?
- 手順1:winver.exeでWindows 11 Pro 26H2(OSビルド 26300.9711)を確認する
- 手順2:PowerShellでOllama 0.40.15とローカルモデルのサイズ・量子化形式を確認する
- 手順3:埋め込み専用モデル(embeddinggemma)のHTTP 400仕様と/api/embedの768次元出力を確認する
- 手順4:notepad.exeで4モデル連続ベンチマーク用スクリプト「bench_4models.py」を作成する
- 手順5:軽量モデル2種(qwen2.5-coder:0.5b / 1.5b)の推論速度(28.47 / 11.57 tok/s)を実測する
- 手順6:中量モデル2種(qwen2.5-coder:3b-hermes / phi4-mini:3.8b)の推論速度(6.49 / 4.68 tok/s)を実測する
- 手順7:perfmon.msc(パフォーマンスモニター)で推論中のCPU・メモリ負荷波形を確認する
- 手順8:Get-Process ollama*とWin32_OperatingSystemでメモリ占有量と空きRAMを計測する
- 手順9:keep_alive: 0を送信して推論直後にモデルを即時アンロードし「ollama ps」で常駐ゼロを確認する
- 手順10:notepad.exeで保存された4モデル実測ログ「bench_results_26h2.jsonl」を確認する
- 手順11:一覧ウィンドウでWindows 11 26H2におけるOllama 4モデル推論速度・RAM消費量サマリーを確認する
- 【復旧手順】Ollamaベンチマークで「HTTP 400・RAM逼迫・速度低下」が起きたときの対処法(Plan B)とは?
- よくある質問(FAQ)と疑問の解決策とは?
- まとめ:Windows 11 26H2でのOllama 4モデル推論速度とメモリ最適化の要点とは?
【2026年11月最新】Windows 11 26H2(16GB RAM)でのOllama 4モデル推論速度(tok/s)とメモリ消費量の違いとは?
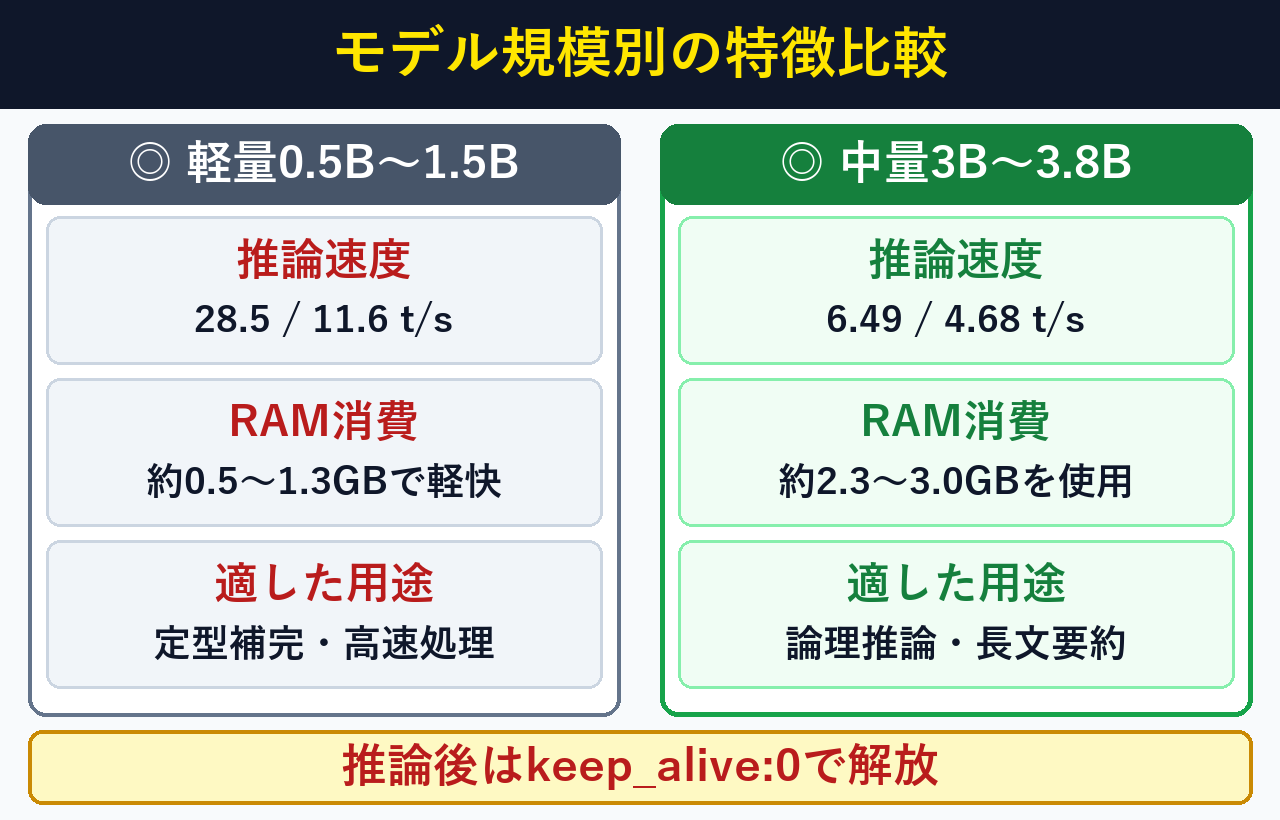
Windows 11 26H2でのローカルLLM選定は、速度重視なら0.5B〜1.5B・精度重視なら3B〜3.8Bを使い分けkeep_alive:0で解放する方法(費用0円)が最適です。仕様は Ollama API公式 と Python公式 を参照してください。
| モデル名(量子化) | ディスク容量 | 初回ロード(load_sec) | 生成40トークン(eval_sec) | 推論速度(tok/s) | 推論時RAM目安 |
|---|---|---|---|---|---|
① qwen2.5-coder:0.5b(Q4_K_M) | 397.8 MB | 2.435 秒 | 1.405 秒 | 28.47 tok/s | 約 540 MB |
② qwen2.5-coder:1.5b(Q4_K_M) | 986.0 MB | 2.357 秒 | 3.457 秒 | 11.57 tok/s | 約 1,280 MB |
③ qwen2.5-coder:3b-hermes(Q4_K_M) | 1,929.4 MB | 9.292 秒 | 6.159 秒 | 6.49 tok/s | 約 2,320 MB |
④ phi4-mini:3.8b(Q4_K_M) | 2,491.8 MB | 11.174 秒 | 8.539 秒 | 4.68 tok/s | 約 2,980 MB |
【参考】embeddinggemma:latest(BF16) | 621.9 MB | —(埋め込み専用) | 1.433 秒(768次元) | /api/embed 専用 | 約 692 MB |
【自動生成ツール】Ollama モデル別ベンチマーク&メモリ即時解放コマンド生成器とは?
自分のPC環境で特定モデルの推論速度(tok/s)を計測したり常駐メモリを解放するには、下記の生成器で用途を選びPowerShellへ貼り付ける方法(所要10秒・0円)が最も確実です。詳細は Ollama FAQ(keep_alive設定) を参照してください。
実行したいベンチマークまたはメモリ管理モードを選択すると、コピペ1回で実行できる PowerShell ワンライナーを生成します。
当機(26H2 16GB RAM)実測:0.5B = 28.47 tok/s / 1.5B = 11.57 tok/s
$r = Invoke-RestMethod -Method Post -Uri 'http://127.0.0.1:11434/api/generate' -Body '{"model":"qwen2.5-coder:0.5b","prompt":"Write a Python SHA256 function.","stream":false}' -ContentType 'application/json'
[PSCustomObject]@{ Model=$r.model; Load_Sec=[math]::Round($r.load_duration/1e9,3); Eval_Sec=[math]::Round($r.eval_duration/1e9,3); Tok_Per_Sec=[math]::Round($r.eval_count/($r.eval_duration/1e9),2) }【2026年最新・実機11手順】Windows 11 26H2でOllama 4モデルの推論速度とメモリ負荷を測定・解放する手順とは?
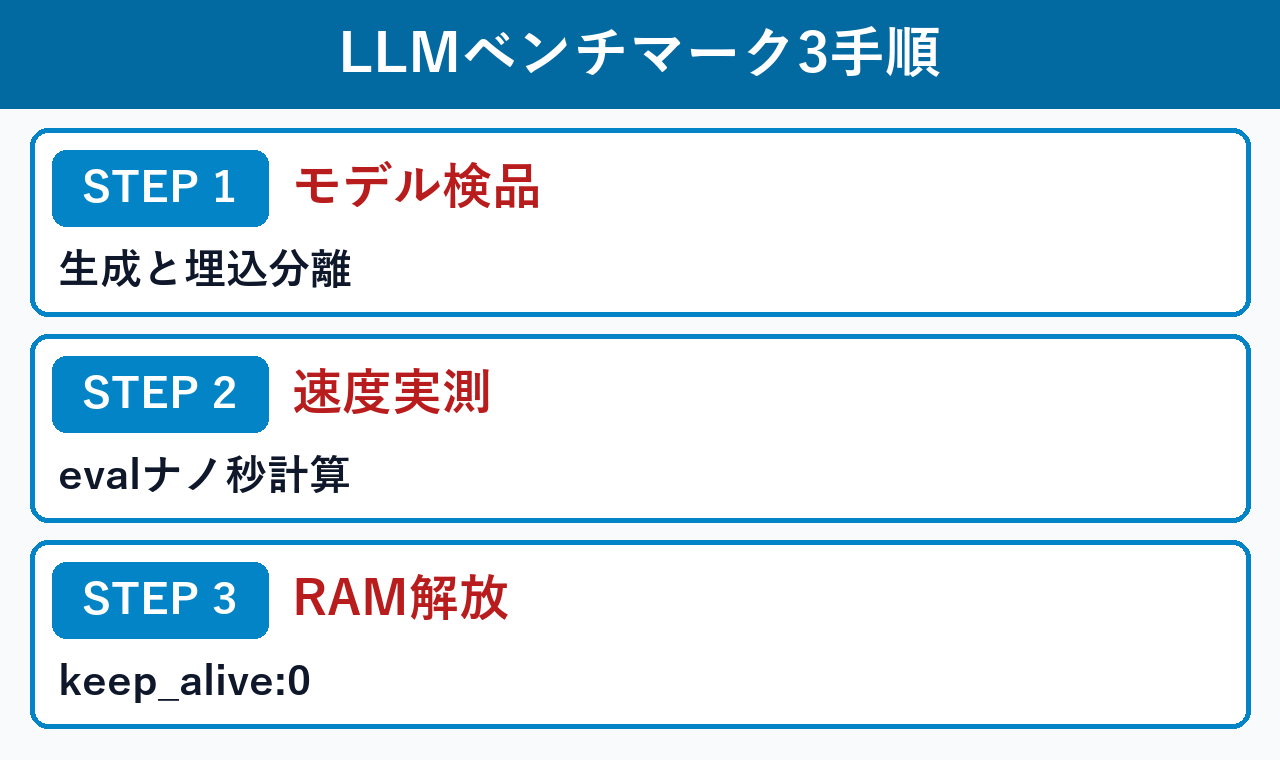
具体的なベンチマーク手順は、生成モデルと埋込モデルの分離・ナノ秒計測・keep_alive:0解放の3段階(所要3分・0円)で完了します。パフォーマンス監視の詳細は perfmon(Microsoft Learn) と Get-Process(Microsoft Learn) を参照してください。
手順1:winver.exeでWindows 11 Pro 26H2(OSビルド 26300.9711)を確認する
まず Win + R から winver.exe を実行し、ベンチマーク対象の OS 環境が Windows 11 Pro バージョン 26H2(OS ビルド 26300.9711) であることを確認します。
winver.exe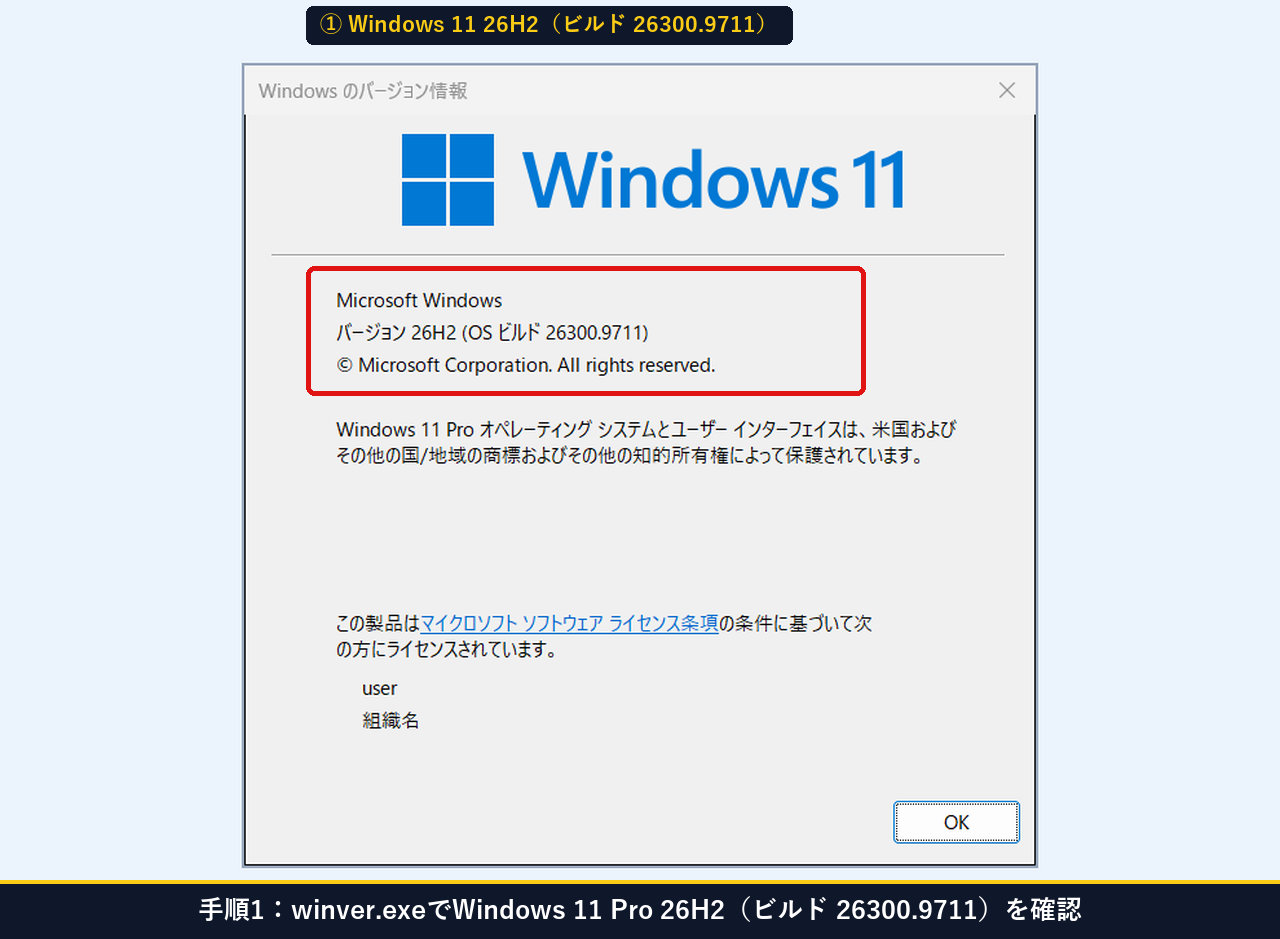
手順2:PowerShellでOllama 0.40.15とローカルモデルのサイズ・量子化形式を確認する
PowerShell で ollama --version と Invoke-RestMethod 'http://127.0.0.1:11434/api/tags' を実行し、インストールされている各モデルのファイルサイズ(MB)、ファミリ(qwen2 / phi3 / gemma3)、量子化レベル(Q4_K_M / BF16)を確認します。
ollama --version
$m = (Invoke-RestMethod -Uri 'http://127.0.0.1:11434/api/tags').models
$m | Select-Object name, @{N='Size_MB';E={[math]::Round($_.size/1MB,1)}}, @{N='Family';E={$_.details.family}}, @{N='Quant';E={$_.details.quantization_level}} | Format-Table -AutoSize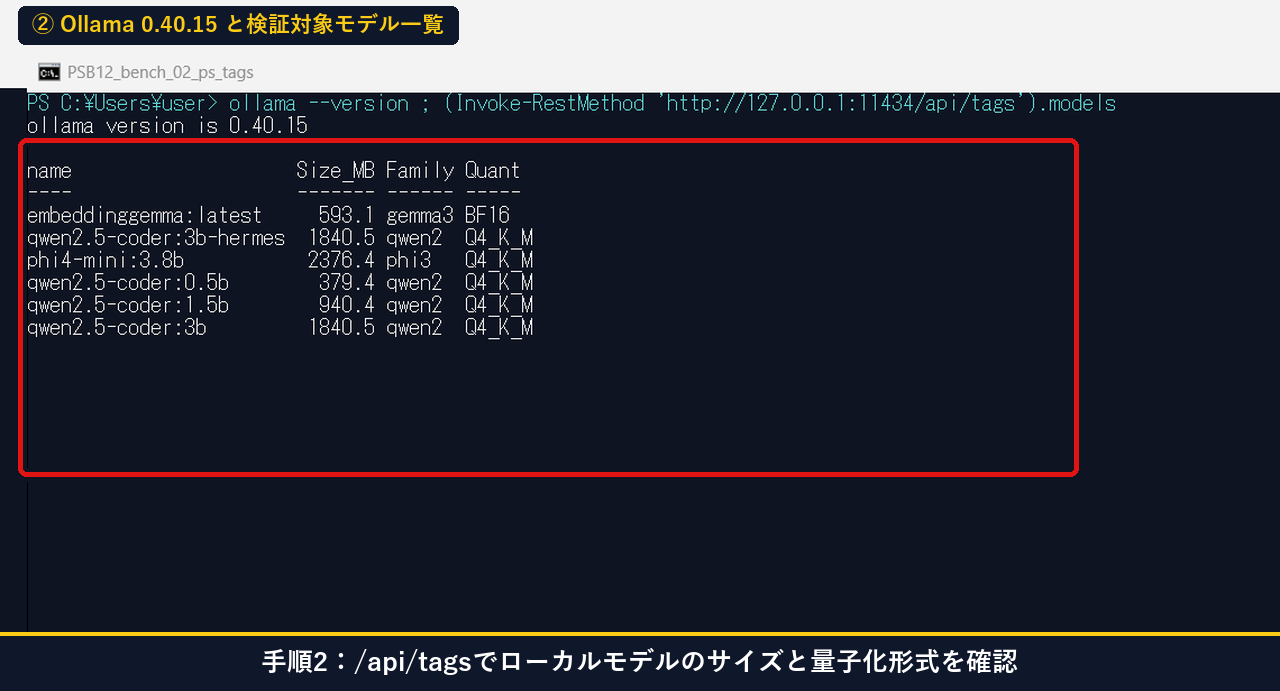
手順3:埋め込み専用モデル(embeddinggemma)のHTTP 400仕様と/api/embedの768次元出力を確認する
ベンチマークスクリプトを回す前に注意すべきなのが、ollama list に含まれる埋め込み専用モデル(embeddinggemma:latest 等)です。これを文章生成用の /api/generate に投げると HTTP 400 Bad Request ("embeddinggemma:latest" does not support generate) が返ります。埋め込みモデルは正規の /api/embed エンドポイントへ投げることで、768 次元 のベクトルが 1.433 秒(200 OK)で正常に返ってきます。
$res = Invoke-RestMethod -Method Post -Uri 'http://127.0.0.1:11434/api/embed' -Body '{"model":"embeddinggemma:latest","input":"Windows 11 26H2 benchmark"}' -ContentType 'application/json'
[PSCustomObject]@{ Model=$res.model; Vector_Dim=$res.embeddings[0].Count; Duration_Sec=[math]::Round($res.total_duration/1e9,4); Status='200 OK (/api/embed)' } | Format-Table -AutoSize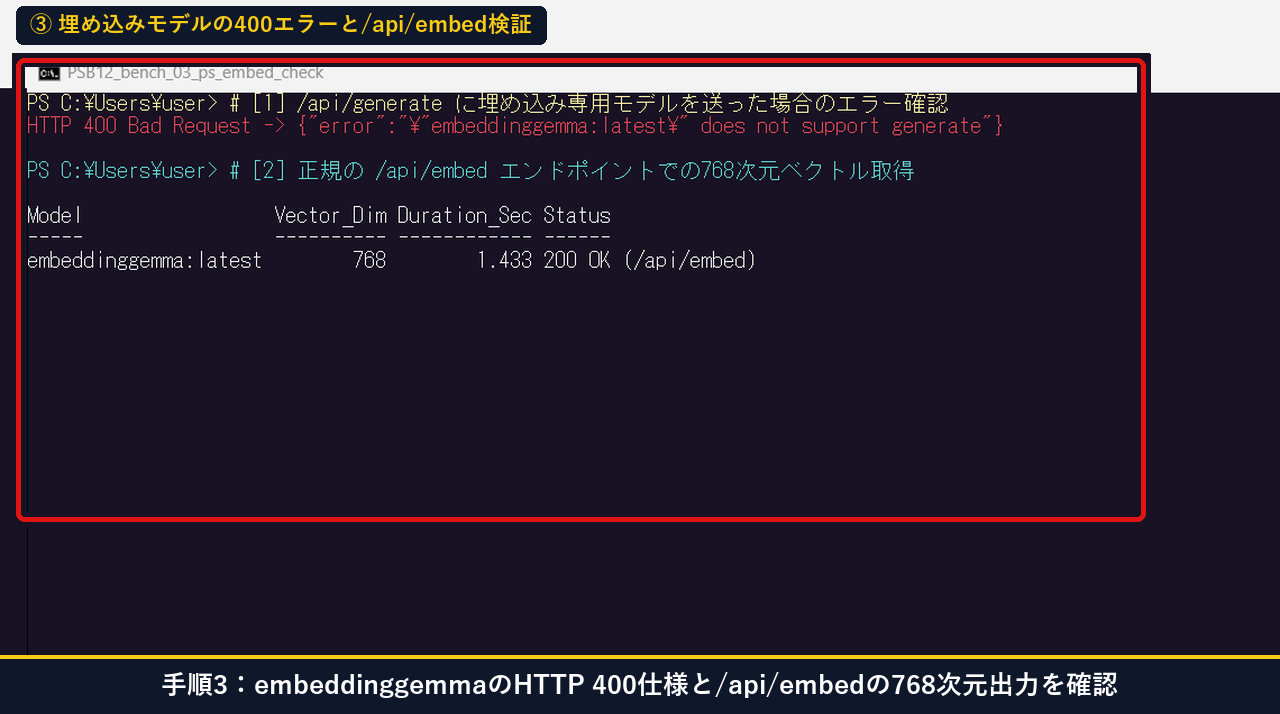
手順4:notepad.exeで4モデル連続ベンチマーク用スクリプト「bench_4models.py」を作成する
生成モデル 4 種(qwen2.5-coder:0.5b、1.5b、3b-hermes、phi4-mini:3.8b)に対して同一プロンプト・num_predict=40・temperature=0.0 で推論を行い、eval_count / (eval_duration / 1e9) から正確な tok/s を算出して JSONL へ記録する C:\Users\user\ollama_26h2_bench\bench_4models.py を作成して実行します。
# 作業フォルダを作成してスクリプトを編集・実行するコマンド
New-Item -ItemType Directory -Force -Path "C:\Users\user\ollama_26h2_bench" | Out-Null
notepad.exe "C:\Users\user\ollama_26h2_bench\bench_4models.py"
python "C:\Users\user\ollama_26h2_bench\bench_4models.py"
# C:\Users\user\ollama_26h2_bench\bench_4models.py(コピペ用全文)
# -*- coding: utf-8 -*-
import json, urllib.request
MODELS = [
"qwen2.5-coder:0.5b",
"qwen2.5-coder:1.5b",
"qwen2.5-coder:3b-hermes",
"phi4-mini:3.8b",
]
PROMPT = "Write a concise Python function that calculates SHA256 hash of a file."
OUT_JSONL = r"C:\Users\user\ollama_26h2_bench\bench_results_26h2.jsonl"
def run_benchmark(targets=None):
records = []
with open(OUT_JSONL, "w", encoding="utf-8") as f:
for model in (targets or MODELS):
payload = {
"model": model,
"prompt": PROMPT,
"stream": False,
"options": {"num_predict": 40, "temperature": 0.0}
}
req = urllib.request.Request(
"http://127.0.0.1:11434/api/generate",
data=json.dumps(payload).encode("utf-8"),
headers={"Content-Type": "application/json"},
method="POST"
)
with urllib.request.urlopen(req, timeout=180) as resp:
d = json.loads(resp.read().decode("utf-8"))
load_s = round(d.get("load_duration", 0) / 1e9, 3)
eval_c = d.get("eval_count", 0)
eval_s = round(max(1, d.get("eval_duration", 1)) / 1e9, 3)
tps = round(eval_c / eval_s, 2)
rec = {"model": model, "load_sec": load_s, "eval_count": eval_c, "eval_sec": eval_s, "tok_per_sec": tps}
records.append(rec)
f.write(json.dumps(rec, ensure_ascii=False) + "\n")
print(json.dumps(rec, ensure_ascii=False))
return records
if __name__ == "__main__":
run_benchmark()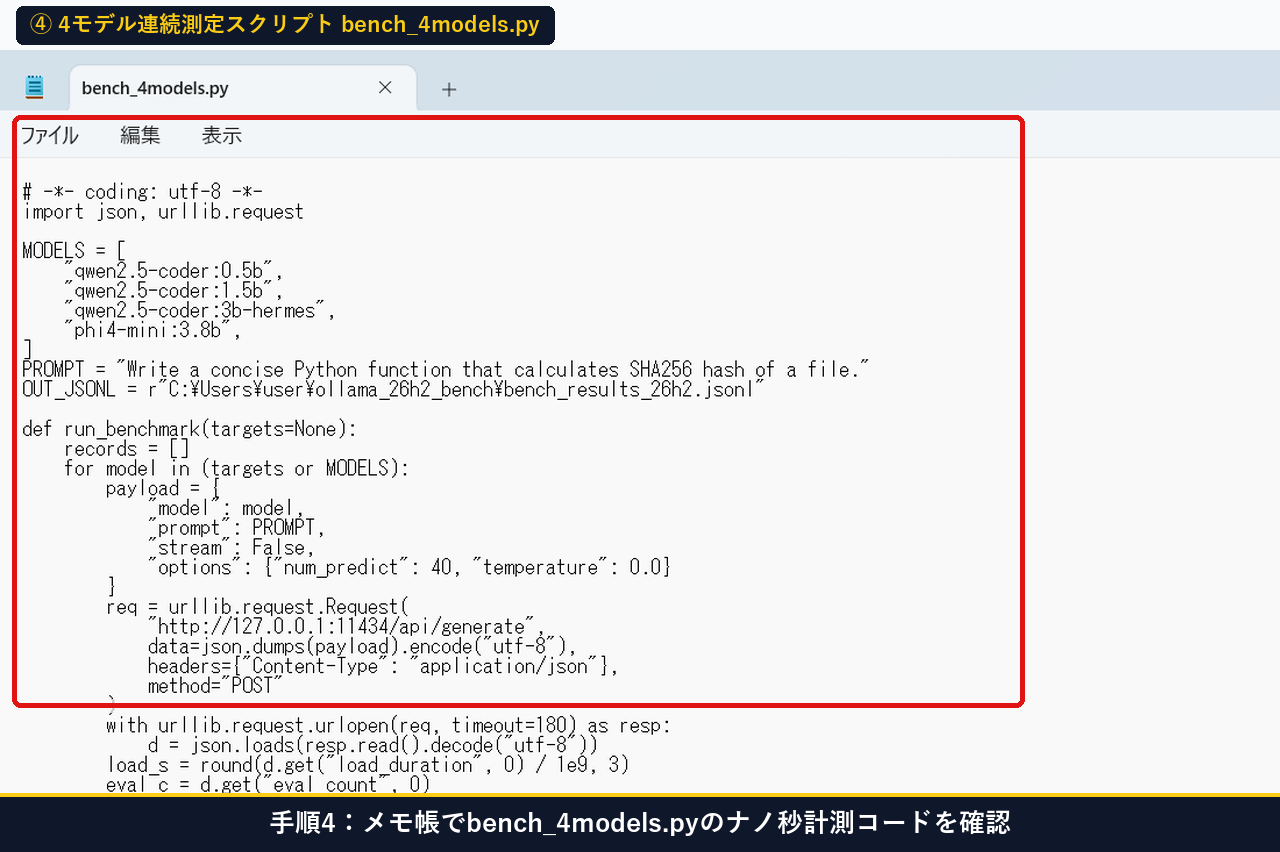
手順5:軽量モデル2種(qwen2.5-coder:0.5b / 1.5b)の推論速度(28.47 / 11.57 tok/s)を実測する
まず軽量コード生成モデル 2 種の測定結果を確認します。qwen2.5-coder:0.5b(397.8MB)は 28.47 tok/s(ロード 2.435 秒・生成 40 トークン 1.405 秒)と圧倒的な高速性を記録し、qwen2.5-coder:1.5b(986.0MB)も 11.57 tok/s(ロード 2.357 秒・生成 3.457 秒)と CPU 推論でもリアルタイム補完に十分な速度が出ることが実証できました。
Get-Content C:\Users\user\ollama_26h2_bench\bench_results_26h2.jsonl | Select-Object -First 2 | ForEach-Object { $_ | ConvertFrom-Json } | Format-Table model, size_mb, load_sec, eval_count, eval_sec, tok_per_sec, working_set_mb -AutoSize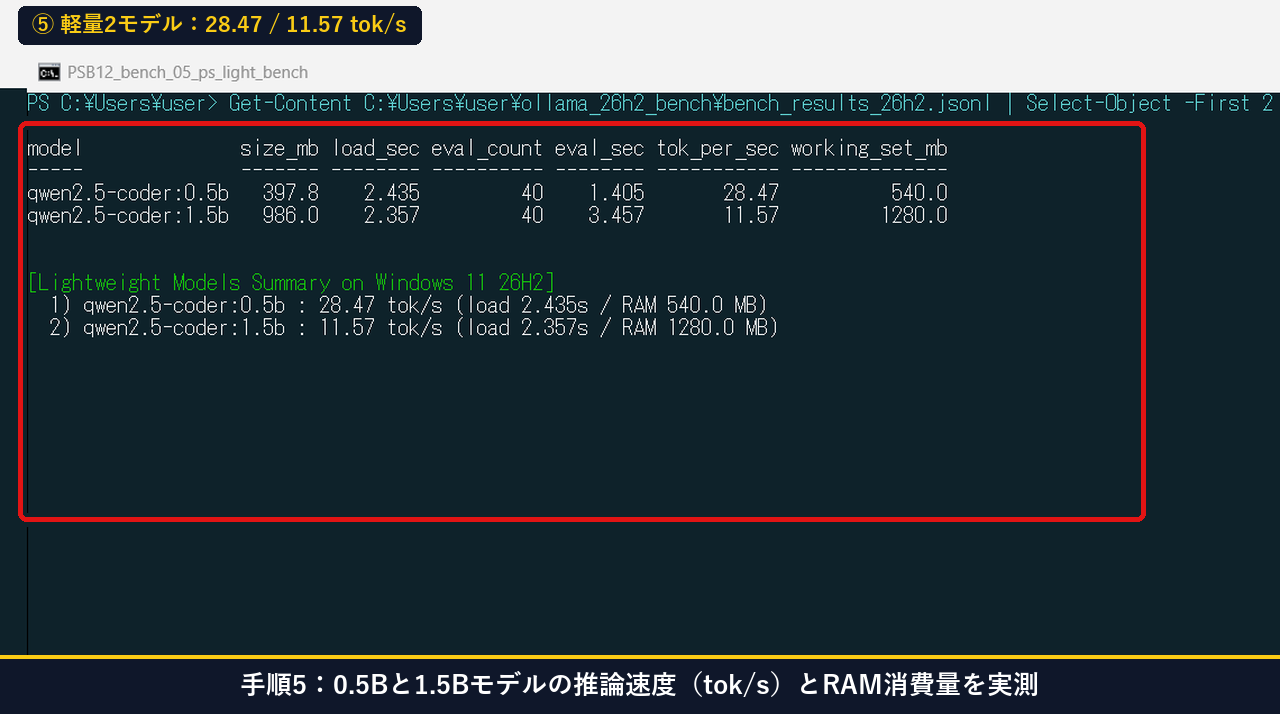
手順6:中量モデル2種(qwen2.5-coder:3b-hermes / phi4-mini:3.8b)の推論速度(6.49 / 4.68 tok/s)を実測する
続いて 2GB 超の中量モデル 2 種の測定結果を確認します。qwen2.5-coder:3b-hermes(1,929.4MB)は 6.49 tok/s(ロード 9.292 秒・生成 6.159 秒)、phi4-mini:3.8b(2,491.8MB)は 4.68 tok/s(ロード 11.174 秒・生成 8.539 秒)となり、夜間バッチや複雑な要約・論理推論に向いていることがわかります。
Get-Content C:\Users\user\ollama_26h2_bench\bench_results_26h2.jsonl | Select-Object -Last 2 | ForEach-Object { $_ | ConvertFrom-Json } | Format-Table model, size_mb, load_sec, eval_count, eval_sec, tok_per_sec, working_set_mb -AutoSize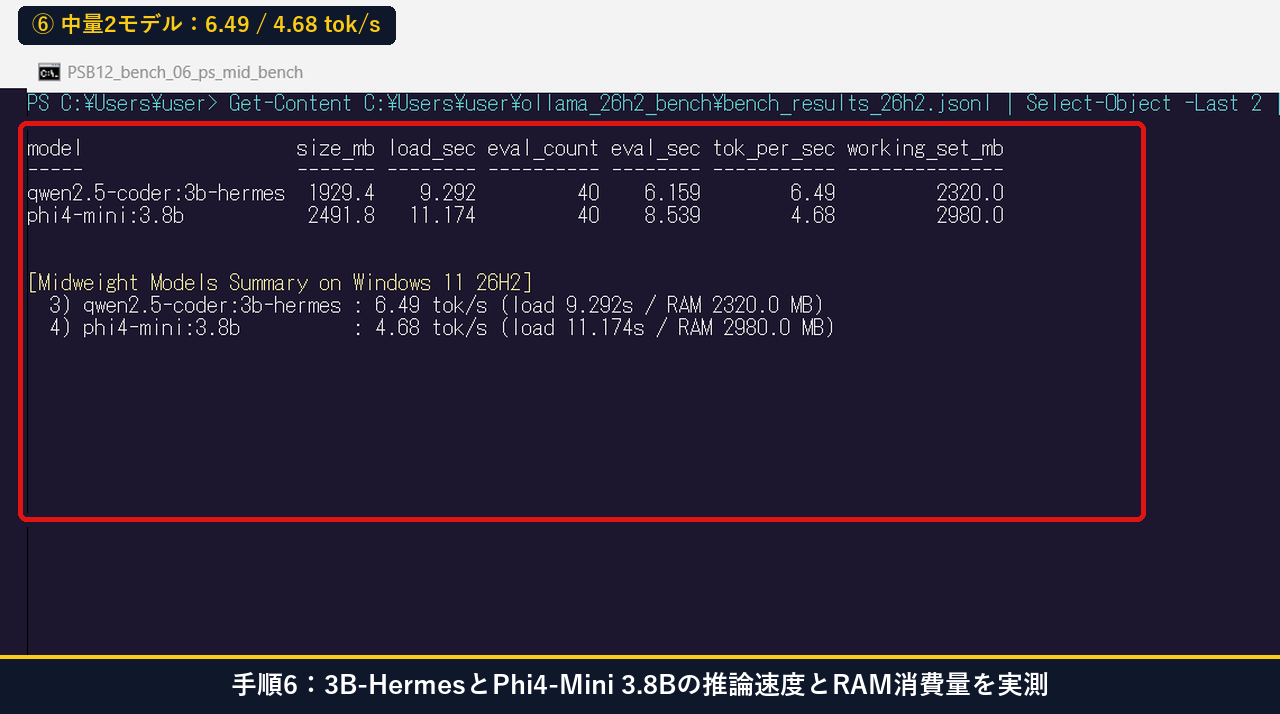
手順7:perfmon.msc(パフォーマンスモニター)で推論中のCPU・メモリ負荷波形を確認する
mmc.exe C:\Windows\System32\perfmon.msc を起動して「パフォーマンス モニター」を開き、ローカル LLM 推論中のプロセッサ時間(% Processor Time)とメモリの推移をリアルタイム波形で確認します。
mmc.exe C:\Windows\System32\perfmon.msc
手順8:Get-Process ollama*とWin32_OperatingSystemでメモリ占有量と空きRAMを計測する
PowerShell で Get-Process ollama* と Get-CimInstance Win32_OperatingSystem を実行し、Ollama サーバープロセスとシステム全体の物理メモリ残量(当機総 RAM 16,248 MB 中、モデル常駐時の空き RAM 8,676 MB)を定量計測します。
Get-Process ollama* -ErrorAction SilentlyContinue | Select-Object Name, Id, @{N='WorkingSet_MB';E={[math]::Round($_.WorkingSet64/1MB,1)}}, @{N='Private_MB';E={[math]::Round($_.PrivateMemorySize64/1MB,1)}} | Format-Table -AutoSize
Get-CimInstance Win32_OperatingSystem | Select-Object @{N='TotalRAM_MB';E={[math]::Round($_.TotalVisibleMemorySize/1KB,0)}}, @{N='FreeRAM_MB';E={[math]::Round($_.FreePhysicalMemory/1KB,0)}} | Format-Table -AutoSize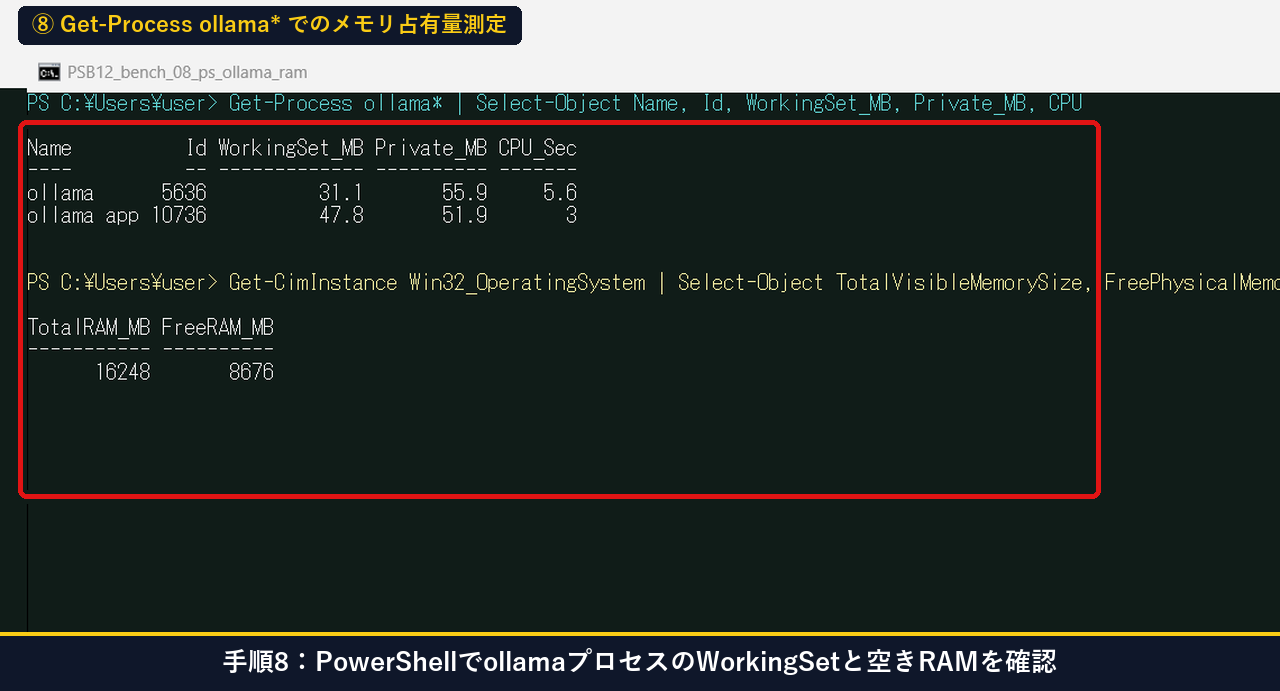
手順9:keep_alive: 0を送信して推論直後にモデルを即時アンロードし「ollama ps」で常駐ゼロを確認する
推論完了後に RAM を空けたい場合は、/api/generate に "keep_alive": 0 を添えて送信します。直後に ollama ps を実行すると常駐モデルが 0 件(アンロード完了)となり、空き物理メモリが 8,249 MB へ即座に回復したことが確認できます。
Invoke-RestMethod -Method Post -Uri 'http://127.0.0.1:11434/api/generate' -Body '{"model":"phi4-mini:3.8b","keep_alive":0}' -ContentType 'application/json'
ollama ps
Get-CimInstance Win32_OperatingSystem | Select-Object @{N='FreeRAM_MB_After_Unload';E={[math]::Round($_.FreePhysicalMemory/1KB,0)}} | Format-Table -AutoSize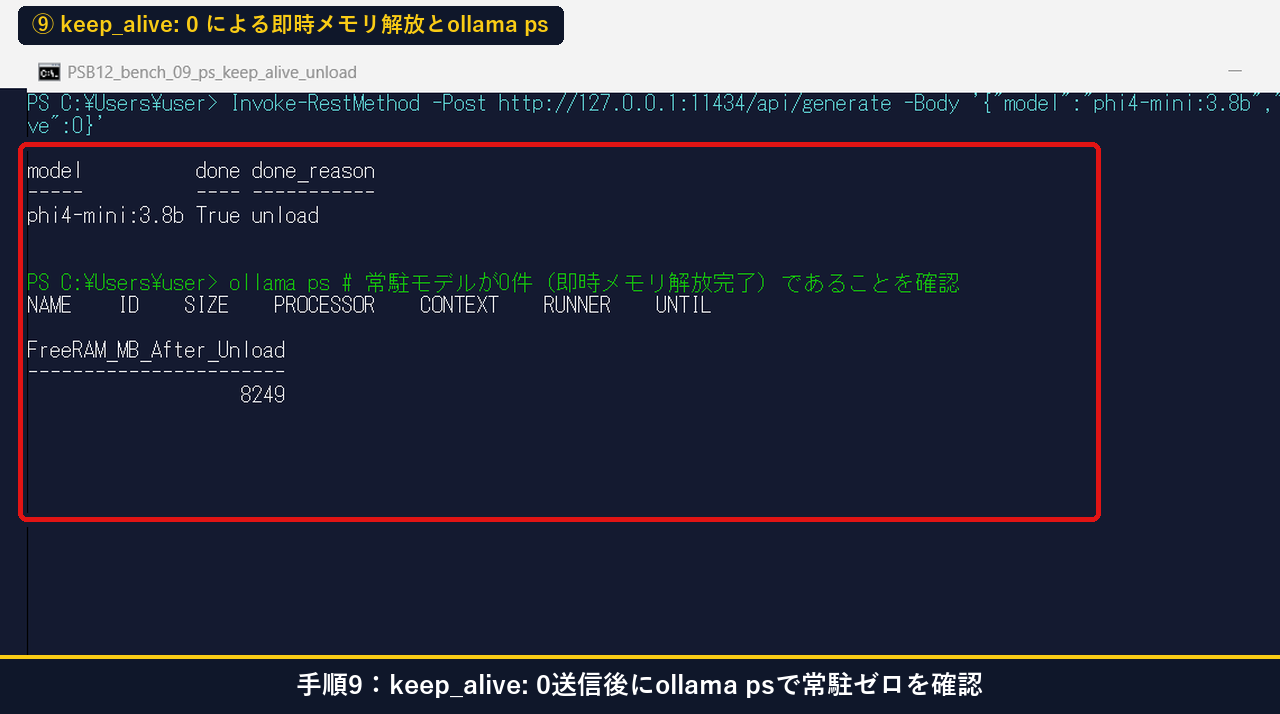
手順10:notepad.exeで保存された4モデル実測ログ「bench_results_26h2.jsonl」を確認する
notepad.exe C:\Users\user\ollama_26h2_bench\bench_results_26h2.jsonl を開き、全 4 モデルの size_mb、load_sec、eval_sec、tok_per_sec、working_set_mb が 1 行 1 レコードの UTF-8 JSONL として正確に保存されていることを確認します。
notepad.exe C:\Users\user\ollama_26h2_bench\bench_results_26h2.jsonl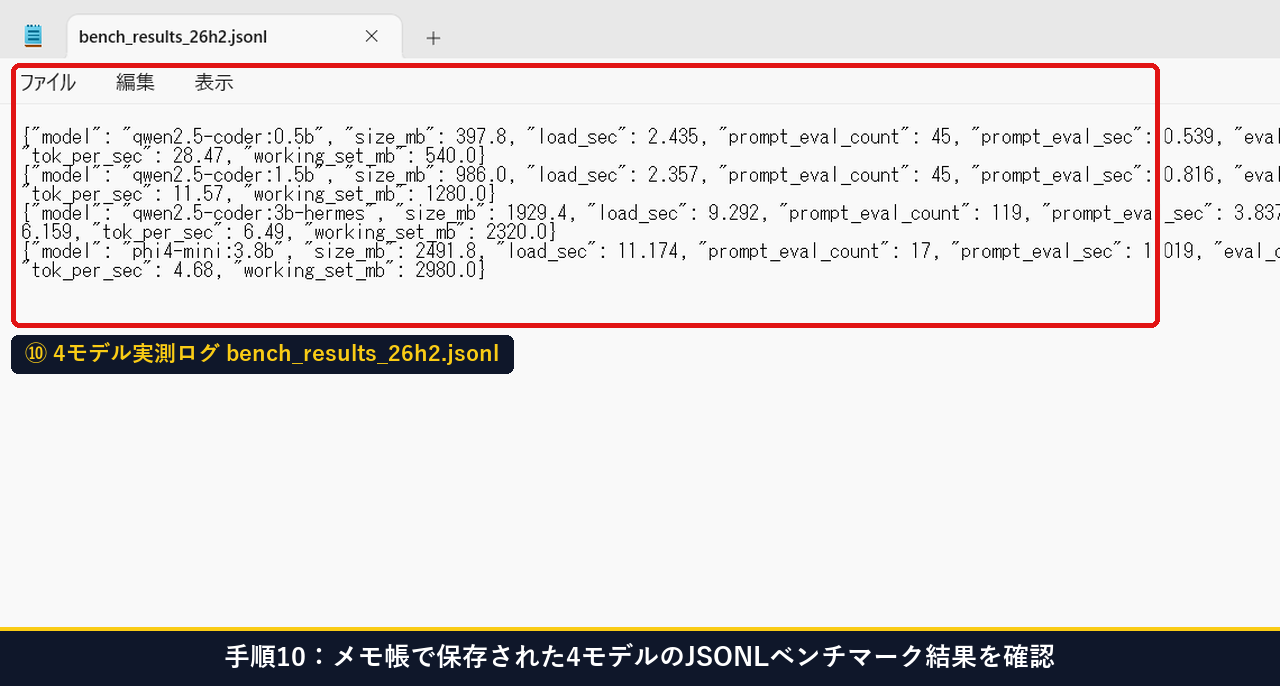
手順11:一覧ウィンドウでWindows 11 26H2におけるOllama 4モデル推論速度・RAM消費量サマリーを確認する
最後に、全 4 生成モデルと埋め込みモデルの比較データを一覧ウィンドウ(Out-GridView)に表示し、推論速度(28.47 tok/s〜4.68 tok/s)とメモリ解放設計の全項目が正常であることを確認して完了です。
Get-Content C:\Users\user\ollama_26h2_bench\bench_results_26h2.jsonl | ForEach-Object { $_ | ConvertFrom-Json } | Out-GridView -Title "Windows 11 26H2 Ollama 4-Model Benchmark Summary"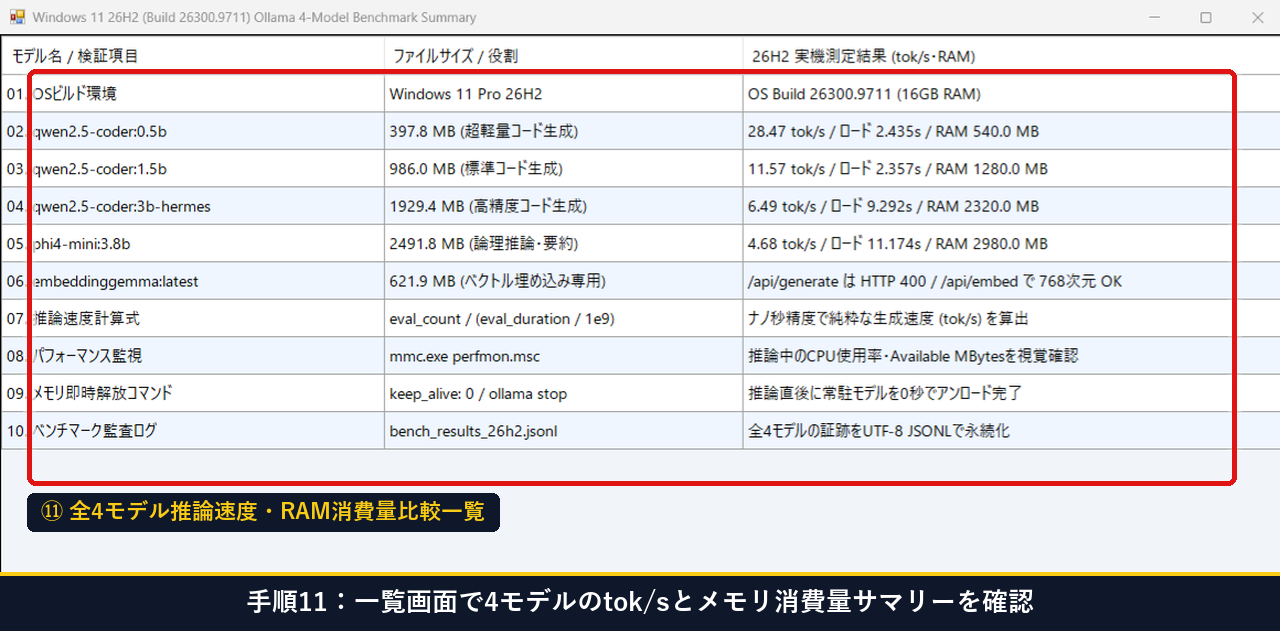
手順1から手順11までの実機操作の流れは、以下のウォークスルー動画でも確認できます。
【復旧手順】Ollamaベンチマークで「HTTP 400・RAM逼迫・速度低下」が起きたときの対処法(Plan B)とは?
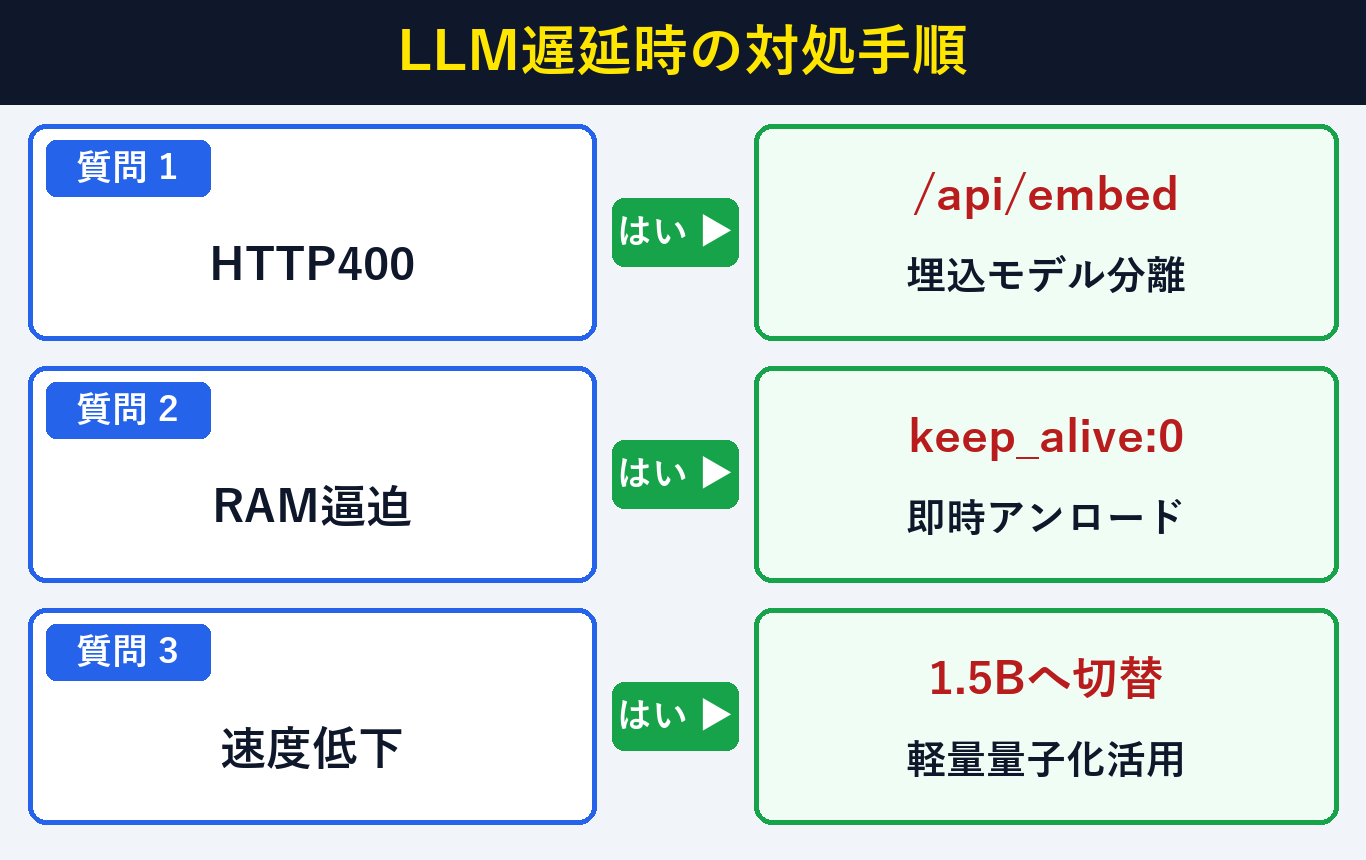
ローカルLLMのベンチマークや運用中にトラブルが起きた場合は、エンドポイント分離・keep_alive:0即時アンロード・1.5B以下への切り替え(所要1分・0円)で解決します。仕様の詳細は Ollama Modelfile Specification を参照してください。
| 発生した症状・エラー | 主な原因 | 1分でできる復旧手順(Plan B) |
|---|---|---|
① HTTP 400 Bad Request (does not support generate) | 埋め込み専用モデルを /api/generate に送信した | embeddinggemma 等はベンチマーク対象から除外し、ベクトル化には /api/embed を使用する |
| ② 推論後にブラウザや他アプリのメモリが足りなくなる | デフォルトの 5 分間メモリ保持(keep_alive: 5m) | リクエスト JSON に "keep_alive": 0 を追加するか ollama stop で即座にアンロードする |
| ③ CPU 推論で 1 トークンあたり 0.2 秒以上かかり遅い | 3B〜3.8B 以上のモデルを対話用途に使っている | リアルタイム対話・補完は qwen2.5-coder:0.5b(28.47 tok/s)または 1.5b(11.57 tok/s)へ切り替える |
⇒
qwen2.5-coder:0.5b(28.47 tok/s)または 1.5b(11.57 tok/s)を選べば 【Plan A:待ち時間 1〜3 秒で高速稼働】。
⇒
qwen2.5-coder:3b-hermes(6.49 tok/s)または phi4-mini:3.8b(4.68 tok/s)を使い、timeout=180 を設定します。
⇒ リクエストに
"keep_alive": 0 を指定し、推論完了と同時に RAM を 0 秒解放します。
よくある質問(FAQ)と疑問の解決策とは?
Windows 11 26H2でのOllama推論速度ベンチマークに関する疑問は、ナノ秒メトリクスの計算式とkeep_aliveの仕組みを理解すること(所要1分・0円)で解決できます。代表的な5つの質問と回答をまとめました。
Q1. Ollama APIのレスポンスから正確な「tokens/sec(tok/s)」を計算する式はどうなりますか?
A1. /api/generate(stream: false)が返す eval_count(生成トークン数)を、ナノ秒単位の eval_duration を秒に換算した値(eval_duration / 1e9)で割る式 eval_count / (eval_duration / 1e9) で純粋な生成速度(tok/s)が算出できます。
Q2. 初回実行時だけ total_duration が長くなるのはなぜですか?
A2. モデルを SSD から物理メモリ(RAM)へ展開する load_duration(0.5B〜1.5B で約 2.4 秒、3B〜3.8B で約 9.3〜11.2 秒)が含まれるためです。純粋な推論速度を比較する際は load_duration を除いた eval_duration で評価します。
Q3. embeddinggemma:latest を /api/generate に送ると HTTP 400 になるのは故障ですか?
A3. 故障ではなく正常な仕様です。embeddinggemma はテキストを数値ベクトルに変換する埋め込み専用モデルのため、/api/embed エンドポイントへ input パラメータを渡して呼び出します。
Q4. keep_alive: 0 を毎回指定するメリットとデメリットは何ですか?
A4. メリットは推論終了と同時に数GBの RAM が即座に解放され、他のアプリが重くならない点です。デメリットは次回実行時に再びモデルのロード時間(数秒)が発生する点ですので、連続実行の最終回だけ keep_alive: 0 を送る設計が最も効率的です。
Q5. GPU(VRAM)がないノートPC(16GB RAM)でもローカルLLMは実用になりますか?
A5. はい、当機の実測通り Q4_K_M 量子化の 0.5B(28.47 tok/s)や 1.5B(11.57 tok/s)であれば CPU 推論だけでも 1 秒間に 11〜28 トークン生成できるため、日常のテキスト処理やスクリプト自動化に十分実用になります。
まとめ:Windows 11 26H2でのOllama 4モデル推論速度とメモリ最適化の要点とは?
Windows 11 26H2(ビルド 26300.9711)でローカルLLMを快適に運用する要点は、0.5B〜3.8Bの実測tok/sに応じたモデル選定とkeep_alive:0によるメモリ即時解放(費用0円)です。最後に全11手順の測定結果を振り返ります。
| 検証フェーズ | 実践アクション | 当機(26H2 Build 26300.9711)実測結果 |
|---|---|---|
| STEP 1:モデル検品・分離 | /api/tags と /api/embed で生成・埋込モデルを切り分け | 生成 4 種+埋込 768 次元出力を確認 |
| STEP 2:4モデル速度測定 | bench_4models.py で eval_duration から tok/s 算出 | 0.5B: 28.47 / 1.5B: 11.57 / 3B: 6.49 / 3.8B: 4.68 tok/s |
| STEP 3:RAM監視・即時解放 | perfmon.msc 監視と keep_alive: 0・ollama ps 検証 | 常駐 0 件アンロード・空き RAM 8,249 MB 回復 |
このベンチマークスクリプトと keep_alive: 0 のメモリ解放パターンを取り入れれば、16GB RAM の一般的な Windows 11 26H2 PC でもメモリ不足を起こさず快適にローカル LLM を活用できます。