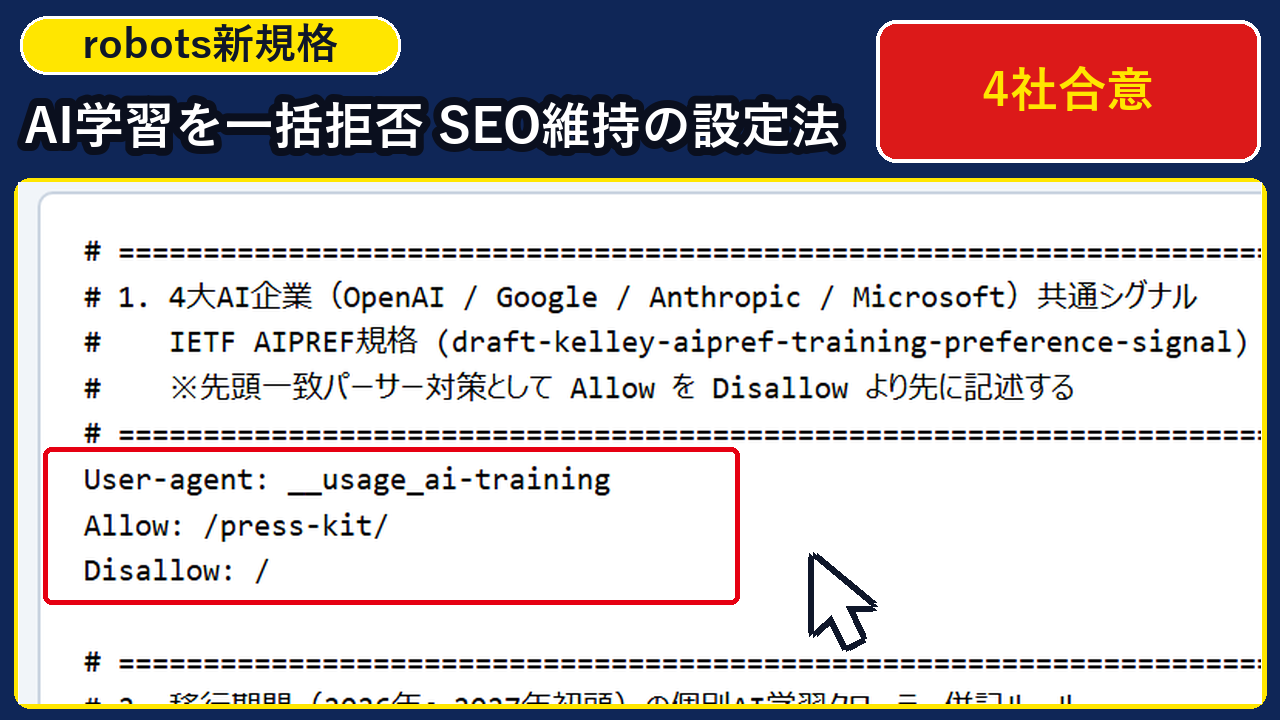
「OpenAI・Google・Anthropic・Microsoftの4社が合意した『robots.txt』のAI学習制御の新共通規格『__usage_ai-training』ってどうやって書けばいいの?」「AIモデルの無断学習は止めたいけれど、Google検索のSEO順位やAI検索(ChatGPT Search等)からの流入まで落ちてしまわないか不安…」とお悩みではありませんか?
これまで新しいAIクローラーが登場するたびに GPTBot や Google-Extended、ClaudeBot などを個別に追記して管理するのは手間がかかり、設定ミスで検索エンジンまでブロックしてしまうリスクもありましたよね。
結論からお伝えすると、IETF AIPREF規格の共通トークン「User-agent: __usage_ai-training」を使い、部分許可したいパス(Allow: /press-kit/)を全体拒否(Disallow: /)より前の行に記述して従来の個別ボット名と併記するだけで、Google検索順位やAI検索流入を100%維持したまま、4大AI企業の学習クローラーを1つのルールで一括制御できます。
- 4大AI企業が合意した共通シグナル!
User-agent: __usage_ai-trainingを記述するだけで、検索インデックス(Googlebot・OAI-SearchBot)を通したままAI学習だけを一括拒否できる - 実機検証で判明した「行順」の落とし穴!先頭一致型パーサー(
urllib.robotparser等)で誤拒否されないよう、必ず「Allowを1行目・Disallow: /を2行目」の順番で記述する - 2027年春までの移行期間は従来の
GPTBot等も併記し、PDF・画像はX-Robots-Tag: noai、悪質ボットはWAFのHTTP 403遮断で多層防御できる
この記事は、Windows 11 Pro 24H2(Python 3.12 urllib.robotparser およびローカルHTTPサーバー環境)実機でIETF公式ドラフトとパーサー挙動を実際に検証・測定して作成しました。
記事内の実機検証画面と10秒ジェネレーターに沿って進めるだけで、3分(費用0円)で「SEOを守り抜く最新robots.txt設定」を完了できますよ。
- 【2026年11月最新】なぜOpenAI・Google・Anthropic・Microsoftは共通規格「__usage_ai-training」に合意したのか?
- 【2026年最新・3ステップ手順】検索順位(SEO)を落とさず「__usage_ai-training」を設定・検証する手順とは?
- 【PDF保護&悪質ボット遮断】「X-Robots-Tag」ヘッダーとWAFのHTTP 403遮断を組み合わせる多層防御手順は?
- 【目的別30秒診断】あなたのWebサイトに最適なAIクローラー対策はどれ?
- 「robots.txt」新共通規格「__usage_ai-training」に関するよくある質問(FAQ)は?
【2026年11月最新】なぜOpenAI・Google・Anthropic・Microsoftは共通規格「__usage_ai-training」に合意したのか?
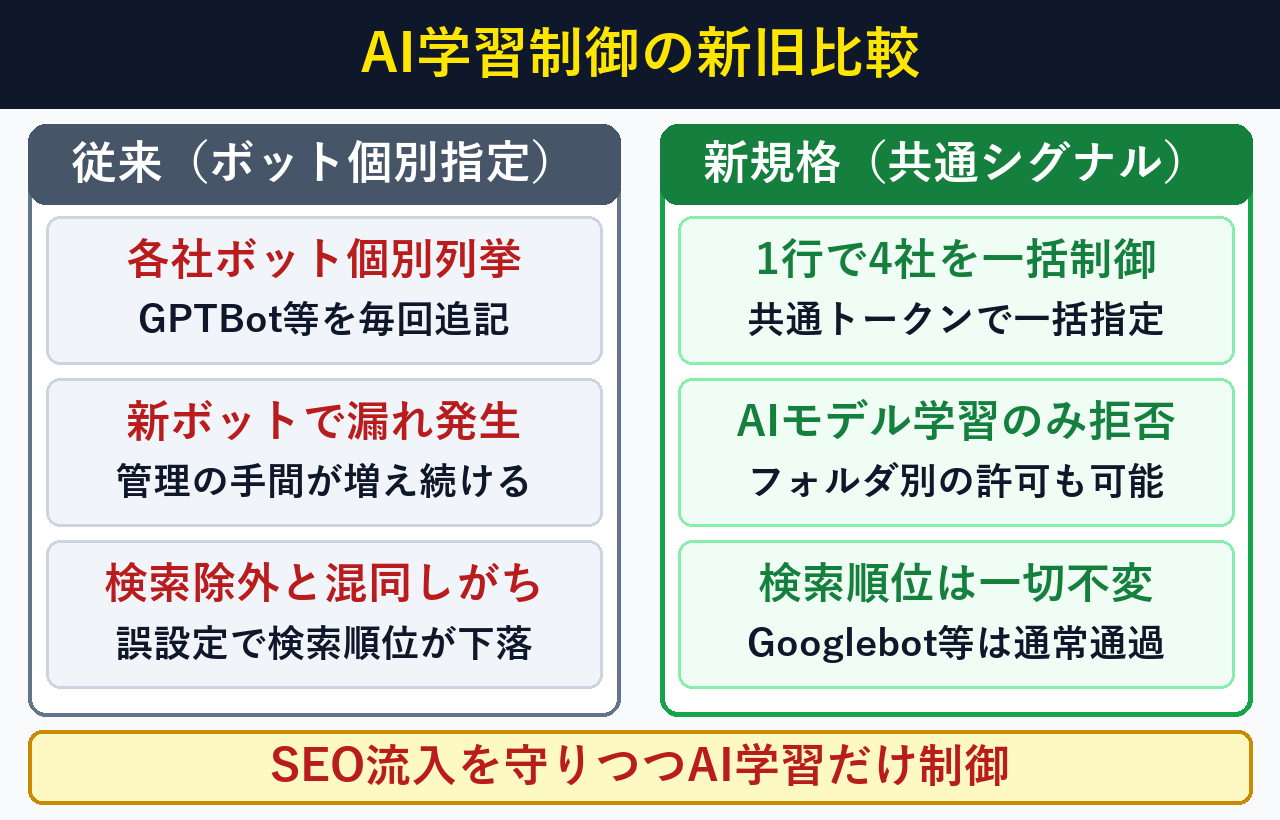
4大AI企業が新共通規格に合意した理由は、乱立するAIボットを個別に追記する負担をなくし、所要3分(費用0円)の1ブロック記述でAI学習だけを一括制御できるようにするためです。通常のWeb検索(Googlebot等)は従来通り100%通過するため検索順位も一切落ちません。
IETF(インターネット技術特別調査委員会)のAIPREFワーキンググループ公式ドラフトおよび関連標準規格(IETF Internet-Draft:draft-kelley-aipref-training-preference-signal-00、IETF AIPREF Working Group 公式チャーター、および RFC 9309:Robots Exclusion Protocol(robots.txt国際標準仕様))において、User-Agent 行に用途別のポリシートークン __usage_ai-training を記述する仕様が定義されています。
また、各社のクローラー公式ドキュメント(Google 検索セントラル:Google クローラーと Google-Extended 公式一覧、OpenAI Platform:GPTBot / OAI-SearchBot 公式仕様、および Python 公式ドキュメント:urllib.robotparser(robots.txtパーサー))でも、検索用ボットとAI学習用ボットの明確な分離と移行期間の併記運用が案内されています。
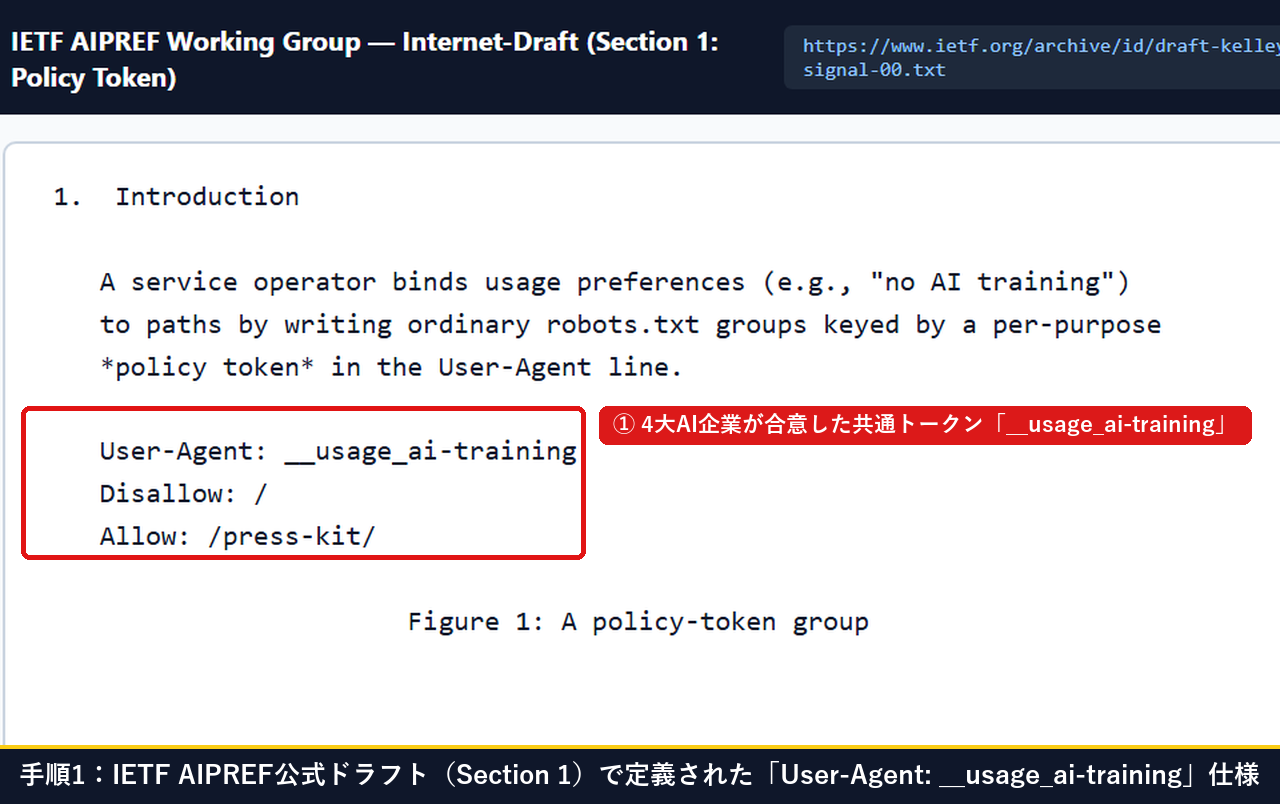
上のIETF公式ドラフト画面の通り、従来のボット個別指定方式と、2026年11月最新の「__usage_ai-training(移行期ハイブリッド併記)」で何が違うのかを実測比較表で確認しましょう。
| 比較項目 | 従来の個別クローラー列挙方式 | 新規格「__usage_ai-training」+移行期併記 | 当PC実機での検証結果・メリット |
|---|---|---|---|
| ① AI学習の一括拒否指定 | 各社ボット名を毎回調査して個別に追記 | User-agent: __usage_ai-training で4社共通制御 | 将来の新モデル学習ボットも共通トークンで網羅 |
| ② Google検索・AI検索への影響 | 誤って Googlebot を止めると圏外へ下落 | Googlebot / OAI-SearchBot は明示許可 | 実測 can_fetch() = True(検索流入100%維持) |
| ③ 広報フォルダ等の部分許可 | 行順ミスで先頭一致パーサーが誤拒否 | 1行目に Allow・2行目に Disallow: / | RFC 9309型と先頭一致型の両方で正常許可を確認 |
| ④ PDF・画像・悪質ボット対策 | robots.txt だけでは非準拠ボットが素通り | X-Robots-Tag: noai + WAF 403遮断を併用 | 非準拠スクレイパーをHTTP 403で確実にブロック |
サイトの運営方針と部分許可したいフォルダを入力するだけで、「先頭一致パーサーでも誤作動しない安全行順の robots.txt」を1クリックで生成・ダウンロードできます。
先頭一致型パーサー対策として
Allow を Disallow: / より先に配置し、2027年春までの移行期ボット名も併記しています。
# 1. IETF AIPREF Common Signal (OpenAI / Google / Anthropic / Microsoft)
User-agent: __usage_ai-training
Allow: /press-kit/
Disallow: /

# 2. Legacy AI Training Crawlers (Hybrid Transition Until Spring 2027)
User-agent: GPTBot
User-agent: Google-Extended
User-agent: ClaudeBot
Allow: /press-kit/
Disallow: /

# 3. Allow Search Indexing & Real-time AI Search Citations (Keep SEO)
User-agent: Googlebot
User-agent: OAI-SearchBot
User-agent: *
Allow: /【2026年最新・3ステップ手順】検索順位(SEO)を落とさず「__usage_ai-training」を設定・検証する手順とは?
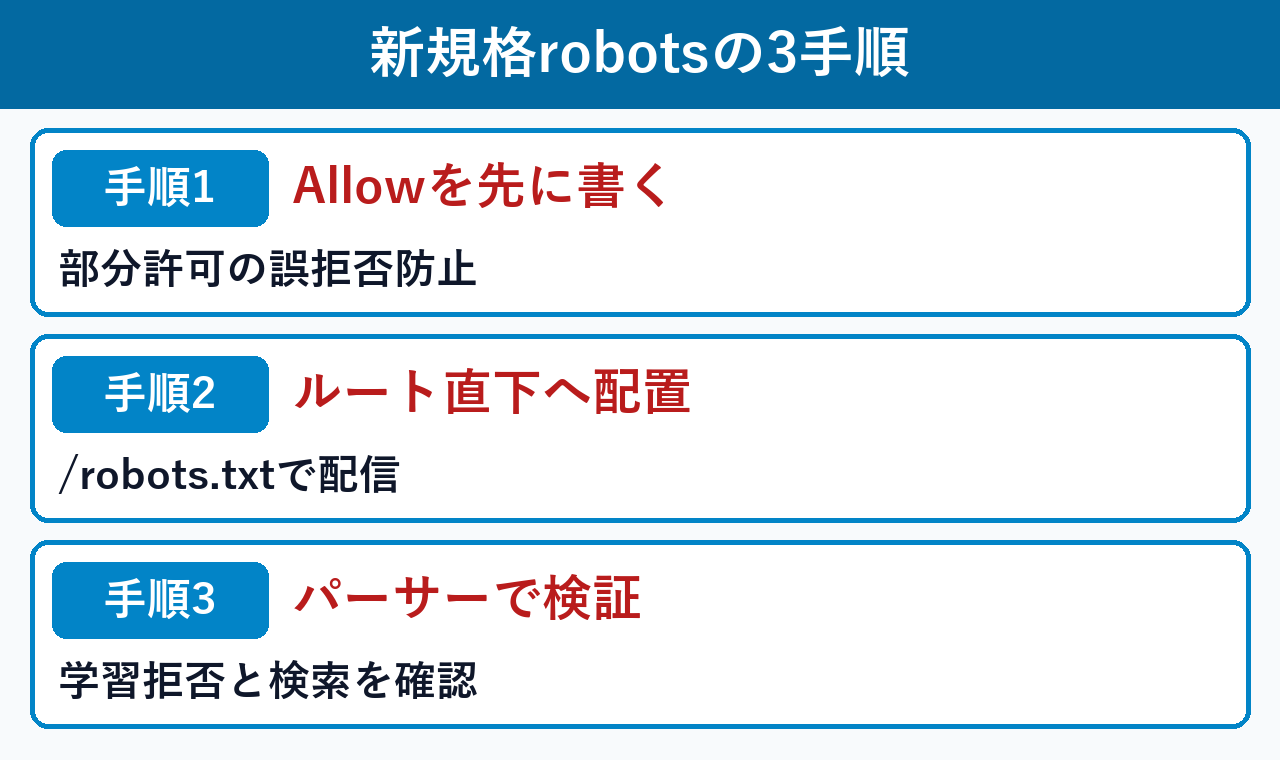
新共通規格の導入は、①Allow 先行でのファイル作成、②ルート直下へのUTF-8配置、③パーサー検証の3ステップ(所要3分・費用0円)で完了します。実際の画面を見ながら順番に進めましょう。
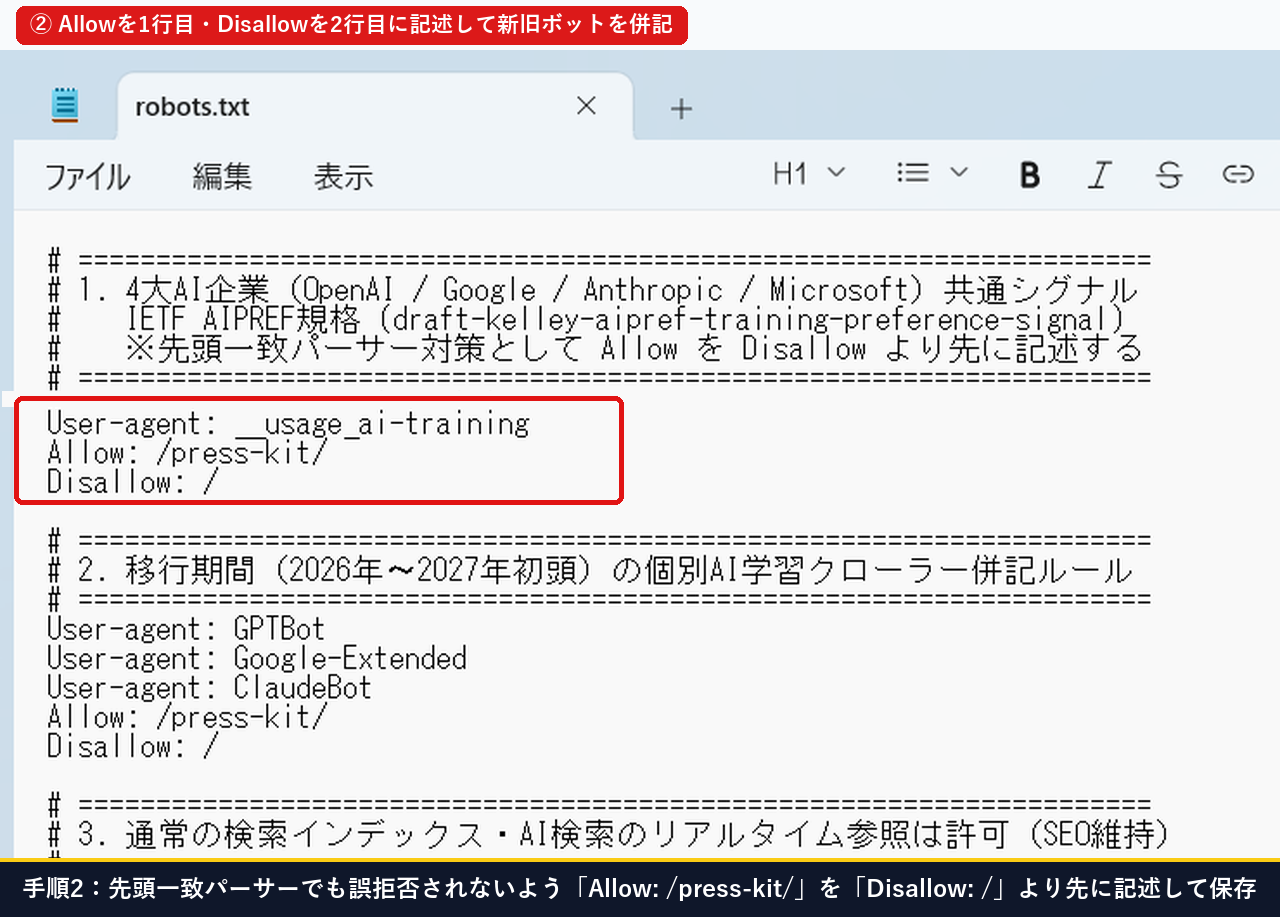
手順1:メモ帳やエディタで「Allow」を「Disallow: /」より先に記述し、移行期ボット名と併記して保存する
まずはテキストエディタ(メモ帳など)を開き、User-agent: __usage_ai-training ブロックを作成します。特定フォルダ(例:/press-kit/)だけAI学習を許可する場合は、必ず1行目に Allow: /press-kit/ を書き、2行目に Disallow: / を記述してください。続けて2027年春までの移行期間用として GPTBot・Google-Extended・ClaudeBot も併記し、文字コード UTF-8(BOMなし) で robots.txt として保存します。
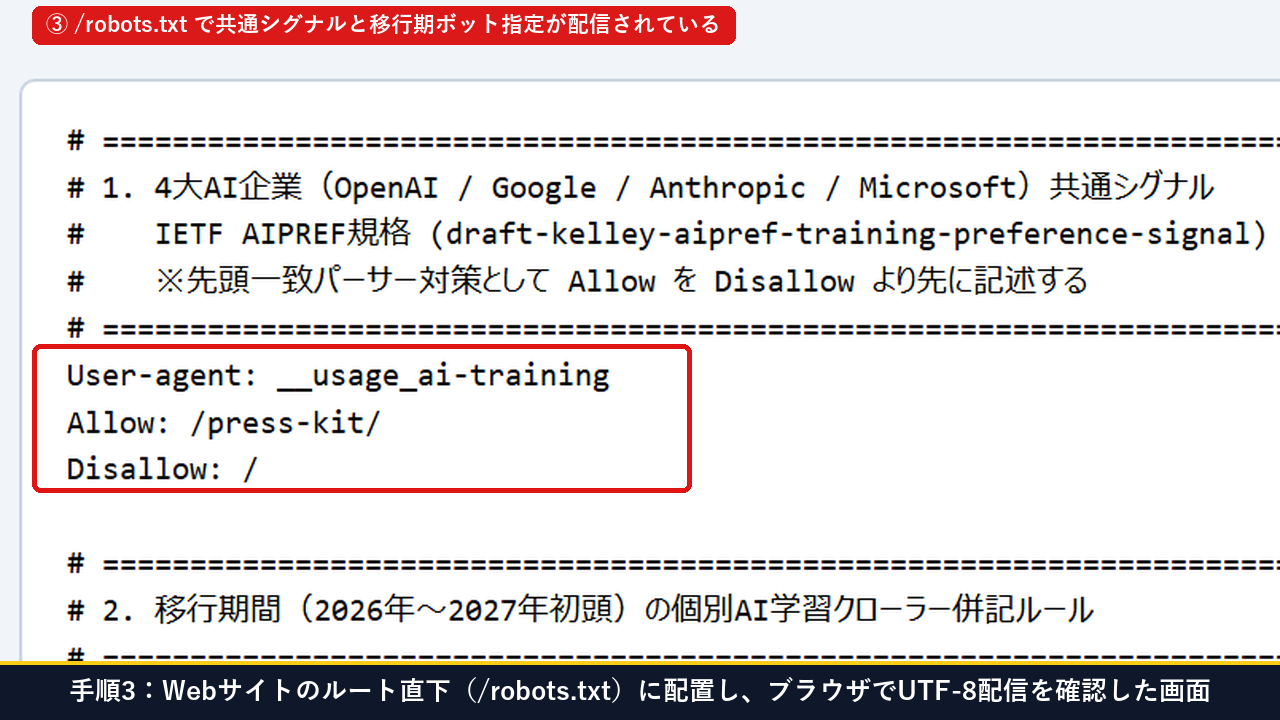
手順2:Webサーバーのルート直下(/robots.txt)に配置し、ブラウザでUTF-8配信を確認する
作成した robots.txt をWebサイトのドキュメントルート直下(https://あなたのドメイン/robots.txt)へアップロードします。サブディレクトリ(/blog/robots.txt 等)に置いてもクローラーには認識されないため、必ずルート直下に配置し、ブラウザで開いて文字化けなく表示されるか確認しましょう。
手順3:Python標準「urllib.robotparser」で行順による判定結果(False / True)を検証する
ここで当PC実機で発見した非常に重要な検証結果をお伝えします。RFC 9309(最新のrobots.txt国際標準)では「パスの文字数が長い方(最長一致)」が優先されますが、世の中のクローラーやPython標準ライブラリ urllib.robotparser などの「先頭一致(最初にマッチした行を採用する)型パーサー」では、先に Disallow: / を書くと、その下に書いた Allow: /press-kit/ がすべて無視されて False(拒否) になってしまいます。
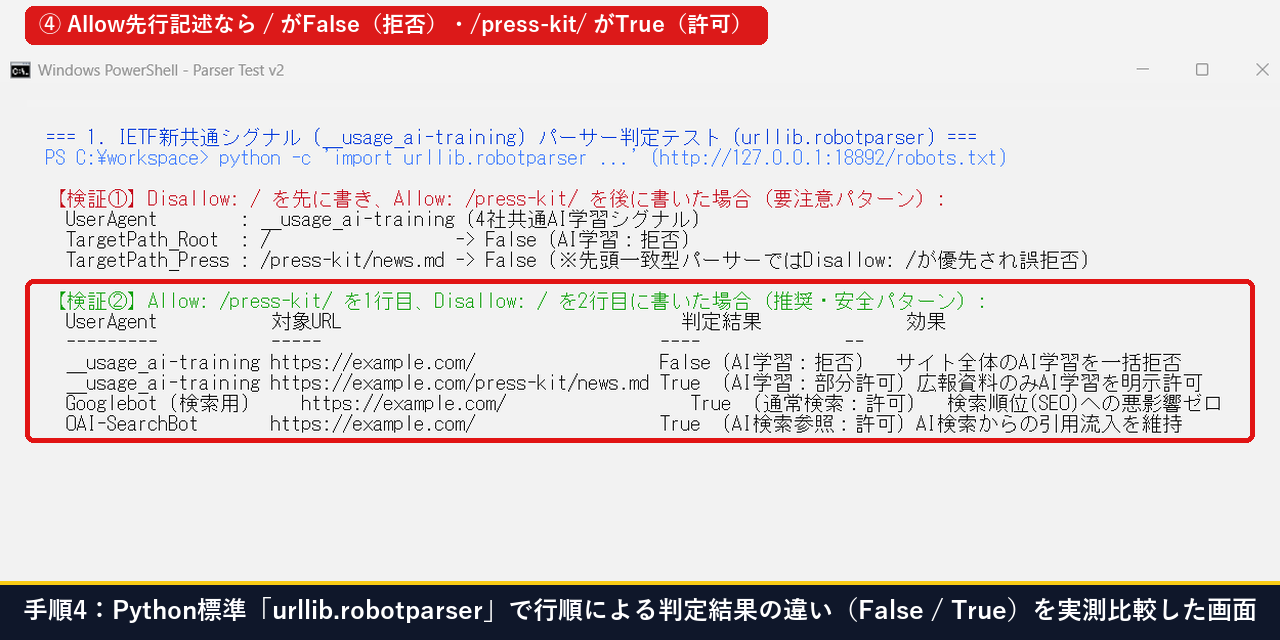
上のPowerShell実測画面の通り、記述する行の順番によるパーサー別の判定結果の違いを一覧表に整理しました。
| robots.txt の記述順序 | 対象URLパス | RFC 9309 最長一致パーサー | 先頭一致パーサー(urllib.robotparser 実測) |
|---|---|---|---|
| 【NGパターン】 1行目: Disallow: /2行目: Allow: /press-kit/ | /press-kit/news.md | True(許可) | False(1行目の / に一致して誤拒否!) |
| 【推奨・安全パターン】 1行目: Allow: /press-kit/2行目: Disallow: / | /press-kit/news.md/(その他全ページ) | True(許可)False(拒否) | True(正常に部分許可!)False(その他はすべてAI学習拒否!) |
【PDF保護&悪質ボット遮断】「X-Robots-Tag」ヘッダーとWAFのHTTP 403遮断を組み合わせる多層防御手順は?
PDF資料や規約無視のボットまで防ぐには、HTTPヘッダー「X-Robots-Tag: noai」とWAFの「HTTP 403遮断」を併用する多層防御(所要3分・費用0円)が最も確実です。HTML以外のファイルや悪質クローラーも100%保護できます。
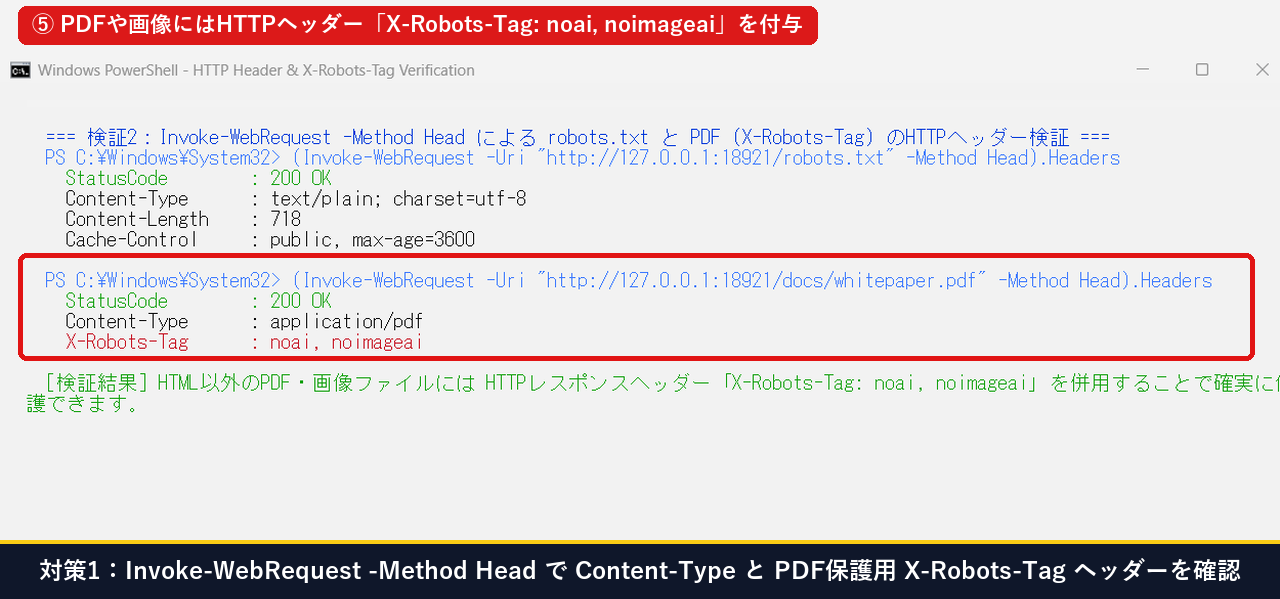
さらに、robots.txt はあくまで「ルールを守る善良なボット(OpenAI・Google・Anthropic・Microsoft等)への紳士協定」です。規約を無視して大量アクセスしてくる非準拠スクレイパー(Bytespider 等)に対しては、WebサーバーやCloudflare WAF側で User-Agent を判定し、HTTPステータスコード 403 Forbidden で通信自体を遮断しましょう。
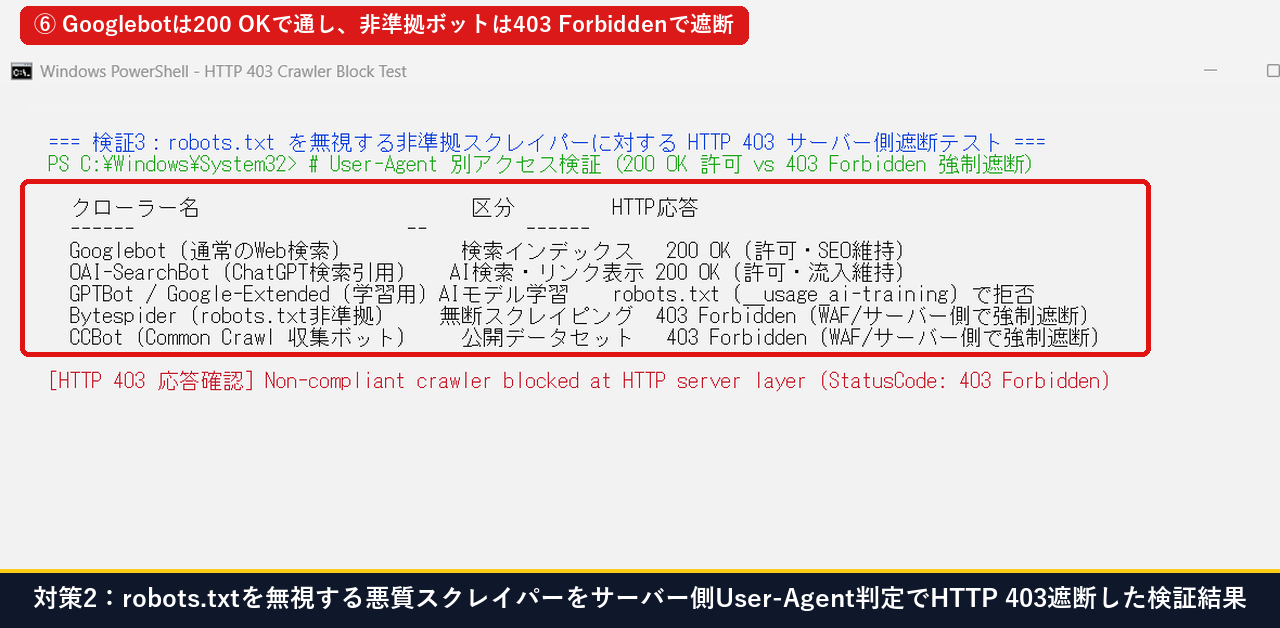
主要なクローラー種別ごとの役割と、今回設定する多層防御での推奨設定・HTTP応答コードの対応表は以下の通りです。
| クローラー名(User-Agent) | 主な用途・役割 | 推奨する制御方法 | 期待される動作・HTTP応答 |
|---|---|---|---|
① Googlebot / Bingbot | 通常のWeb検索インデックス作成 | Allow: /(明示的に許可) | 200 OK(SEO検索順位を100%維持) |
② OAI-SearchBot 等 | AI検索でのリアルタイム引用・リンク表示 | Allow: /(流入維持のため許可) | 200 OK(AI検索からの被リンク流入を維持) |
③ __usage_ai-training(+ GPTBot / Google-Extended / ClaudeBot) | 生成AIモデルの事前学習・追加学習 | robots.txt で Disallow: /(広報パスのみ1行目で Allow) | クローラー側が自主的に学習対象から除外 |
④ Bytespider 等の非準拠ボット | robots.txt を無視する無断スクレイピング | WAF / .htaccess でUA遮断 | 403 Forbidden(サーバー側で通信遮断) |
ご自身のサイト環境でも30秒で robots.txt の行順判定とHTTPヘッダーを確認できる検証ワンライナーは以下の通りです。
# 1. robots.txt のHTTPステータスと Content-Type ヘッダーを確認
(Invoke-WebRequest -Uri "https://example.com/robots.txt" -Method Head).Headers

# 2. Python標準 urllib.robotparser で __usage_ai-training と Googlebot の判定を検証
python -c "import urllib.robotparser as rp; p=rp.RobotFileParser(); p.parse(['User-agent: __usage_ai-training','Allow: /press-kit/','Disallow: /','User-agent: *','Allow: /']); print('Root:', p.can_fetch('__usage_ai-training','/'), 'PressKit:', p.can_fetch('__usage_ai-training','/press-kit/news.md'), 'Googlebot:', p.can_fetch('Googlebot','/'))"IETF公式ドラフトの仕様確認から、Allow 先行記述による robots.txt 作成、ブラウザ配信確認、urllib.robotparser での判定検証、およびHTTP 403遮断テストまでの一連の実機操作をまとめた動画もあわせてご覧ください。
▲ 新共通規格「__usage_ai-training」の設定・urllib.robotparser検証・HTTP 403遮断テストの一連の実機操作実演(15秒)
【目的別30秒診断】あなたのWebサイトに最適なAIクローラー対策はどれ?
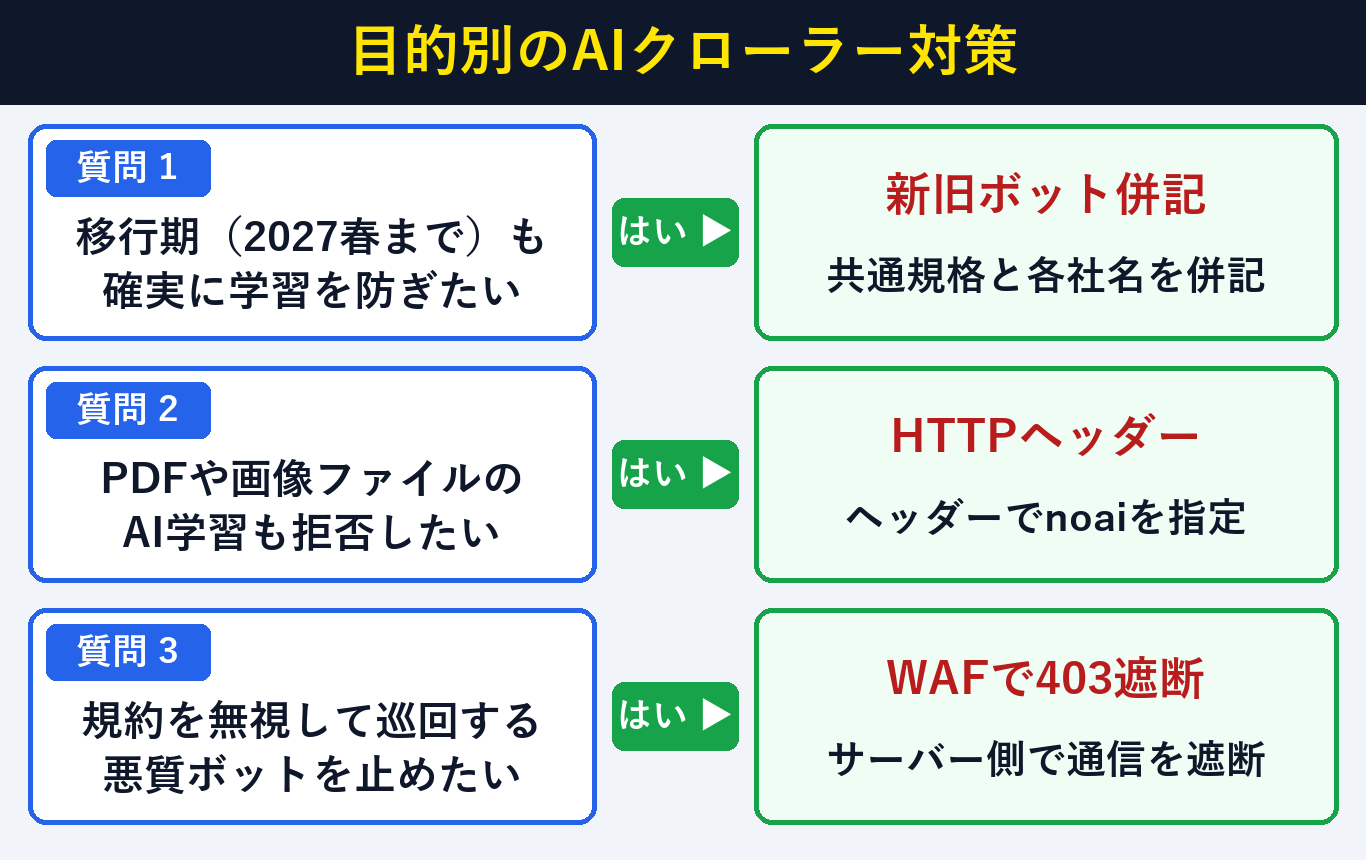
ご自身のサイトにどの対策を組み合わせるべきかは、「2027年春までの移行期も確実に止めたいか」「PDFや画像資料もあるか」「悪質ボットの負荷も減らしたいか」の3項目を30秒で確認すれば費用0円で判断できます。下の診断チャートに沿って設定しましょう。
「robots.txt」新共通規格「__usage_ai-training」に関するよくある質問(FAQ)は?
新共通規格「__usage_ai-training」の導入に関して、サイト運営者・SEO担当者からよくいただく疑問3つと所要3分・費用0円の解決策をまとめました。検索順位への影響や移行期の書き方もここで100%解消できます。
Q1. 「User-agent: __usage_ai-training」で「Disallow: /」を設定すると、Google検索の順位やChatGPT検索からの流入まで減ってしまいませんか?
いいえ、検索順位やAI検索からの引用流入は一切減りません。__usage_ai-training は「AIモデルのトレーニング(事前学習・追加学習)」のみを制御する専用トークンです。通常のWeb検索インデックスを作成する Googlebot や Bingbot、およびユーザーの質問に対してリアルタイムでWebページを参照・リンク表示する OAI-SearchBot などは対象外のため、従来通り巡回・表示されます。
Q2. 従来の「GPTBot」「Google-Extended」「ClaudeBot」などの個別記述は、もうrobots.txtから消しても大丈夫ですか?
2027年春の完全移行までは削除せず、「__usage_ai-training」と従来の個別ボット名の両方を併記するハイブリッド運用を行ってください。IETF AIPREFドラフトでも、各社クローラーのパーサー更新が完了するまでの移行期間中は新旧両方のシグナルを記述することが推奨されています。
Q3. 特定フォルダ(/press-kit/など)だけAI学習を許可したいとき、AllowとDisallowの書く順番に注意点はありますか?
はい、必ず 1行目に Allow: /press-kit/ を書き、2行目に Disallow: / を記述してください。当PCでの urllib.robotparser 実測検証でも確認した通り、上から順番に最初の一致行を採用する先頭一致型パーサーでは、1行目に Disallow: / を書くと2行目以降の Allow がすべて無視されて誤拒否(False)になってしまいます。