AIに自分のサイトを学習されたくないけれど、何をいつ書けばいいのか分からない。この記事では、2026年10月30日に出た新しい書き方と、各社の開始時期が分かります。
書き方は robots.txt に2行足すだけですが、各社が読む時期は会社ごとに違います。Microsoft は2027年2月1日から、巡回して見つけた設定を読みます。Google は2027年、OpenAI は2026年10月30日から数か月以内の対応を目指します。Anthropic は実装を始めたと、個人のメールに書いています。4社とも「もう対応した」とは書いていません。
書き方は、私の PC(Windows 11 Home・ビルド 26200)で解析器に通して確かめました。
- 2026年10月30日に発表された、AI学習の拒否を伝える新しい書き方は、各社いつから読むの?
- robots.txt に何を書くと、AIに学習されたくない意向を伝えられるの?
- 全部拒否の行を書いてあれば、AI学習も拒否したことになる?
- AI学習の拒否の行を足すと、検索結果から消えたり、巡回に影響したりする?
- NoArchive/NoCache を使っているサイトは、Microsoft の2027年3月1日までに何をするの?
- 解析器によって、同じ robots.txt の読み方が割れるって本当?
- AI学習の拒否の書き方は、もう正式な決まりなの?
- 結局、いま私は何をすればいいの?
- この記事に出てくる言葉
- 参考にした公式ページ
2026年10月30日に発表された、AI学習の拒否を伝える新しい書き方は、各社いつから読むの?
2026年10月30日に Google・OpenAI・Microsoft が発表を出しました。Anthropic は、インターネットの決まりを話し合う集まりのメールで状況を書いています。違いは、目標なのか、日付なのかです。
| 会社 | 発表の語 | 時期の言い方 | 出どころ |
|---|---|---|---|
| 2027年に対応を目指す | 目標(日付ではない) | Google の発表(公式ブログ) | |
| OpenAI | 今後数か月以内の対応を目指す | 目標。起点は2026年10月30日 | OpenAI の発表(日本語) |
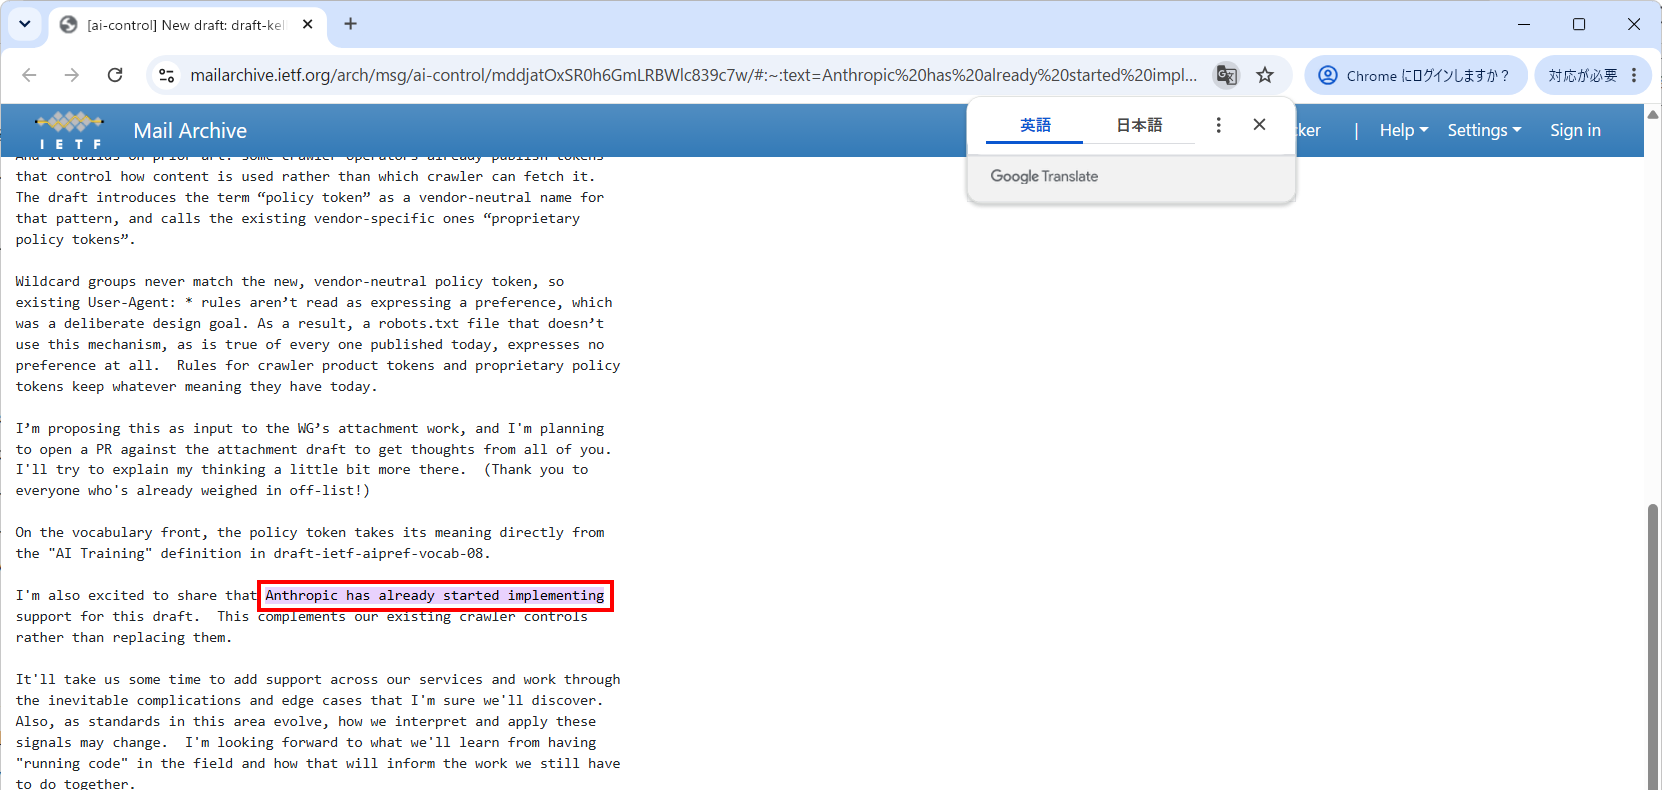
| Anthropic | 実装を始めた。全サービスに広げるには時間がかかる | 個人のメールの文 | IETF のメール(ai-control) |
| Microsoft | 2027年2月1日から、新しい設定を読む | 日付 | Bing の発表(公式ブログ) |
Anthropic は会社の発表ではなく、個人のメールの文です。OpenAI と Anthropic の動きは、ITmedia の記事も伝えています。
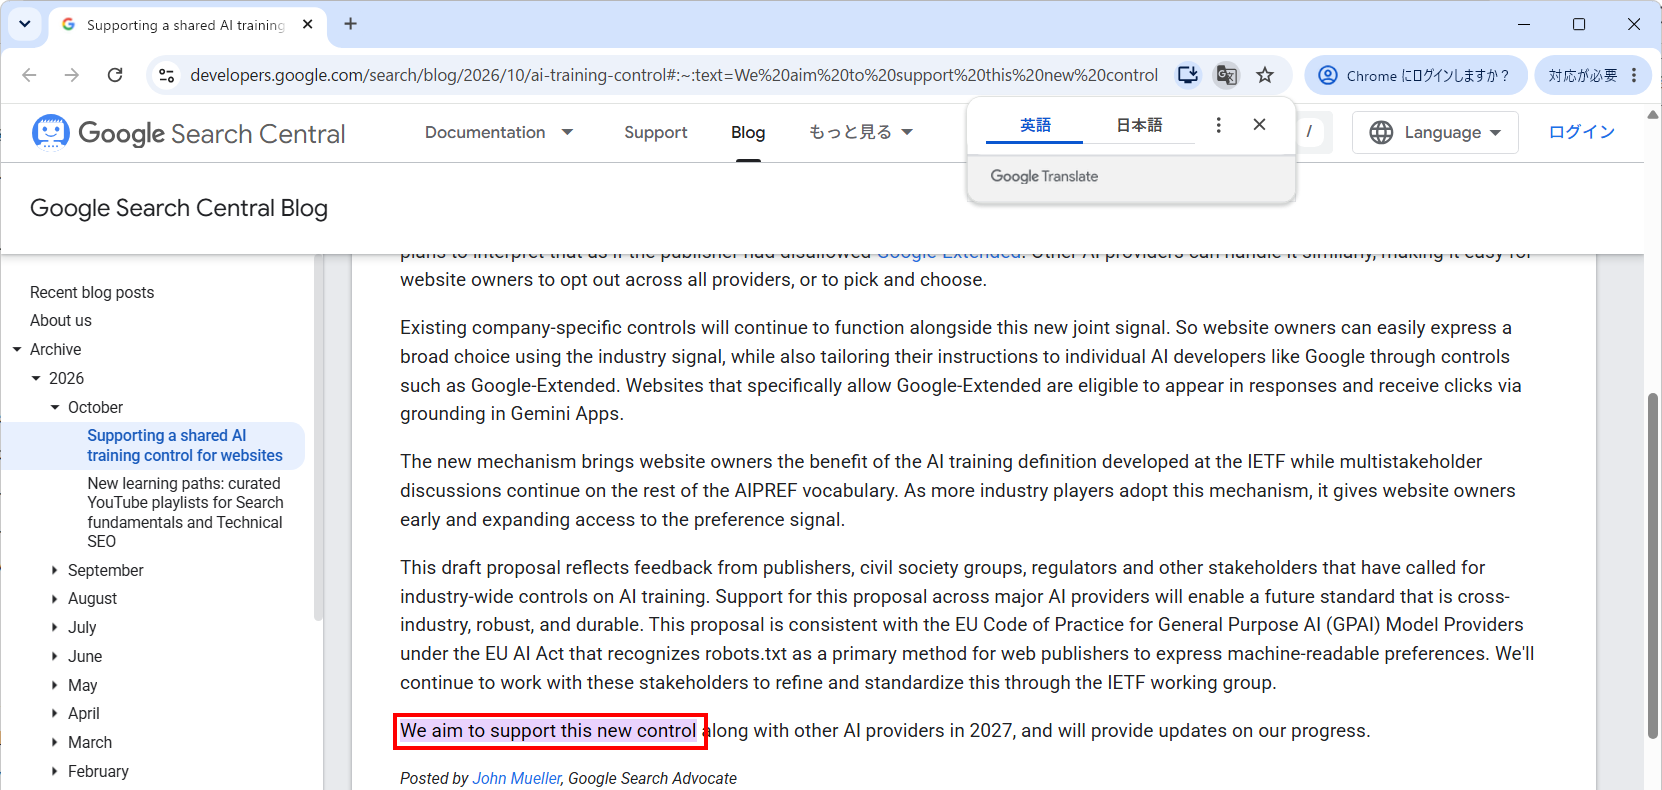
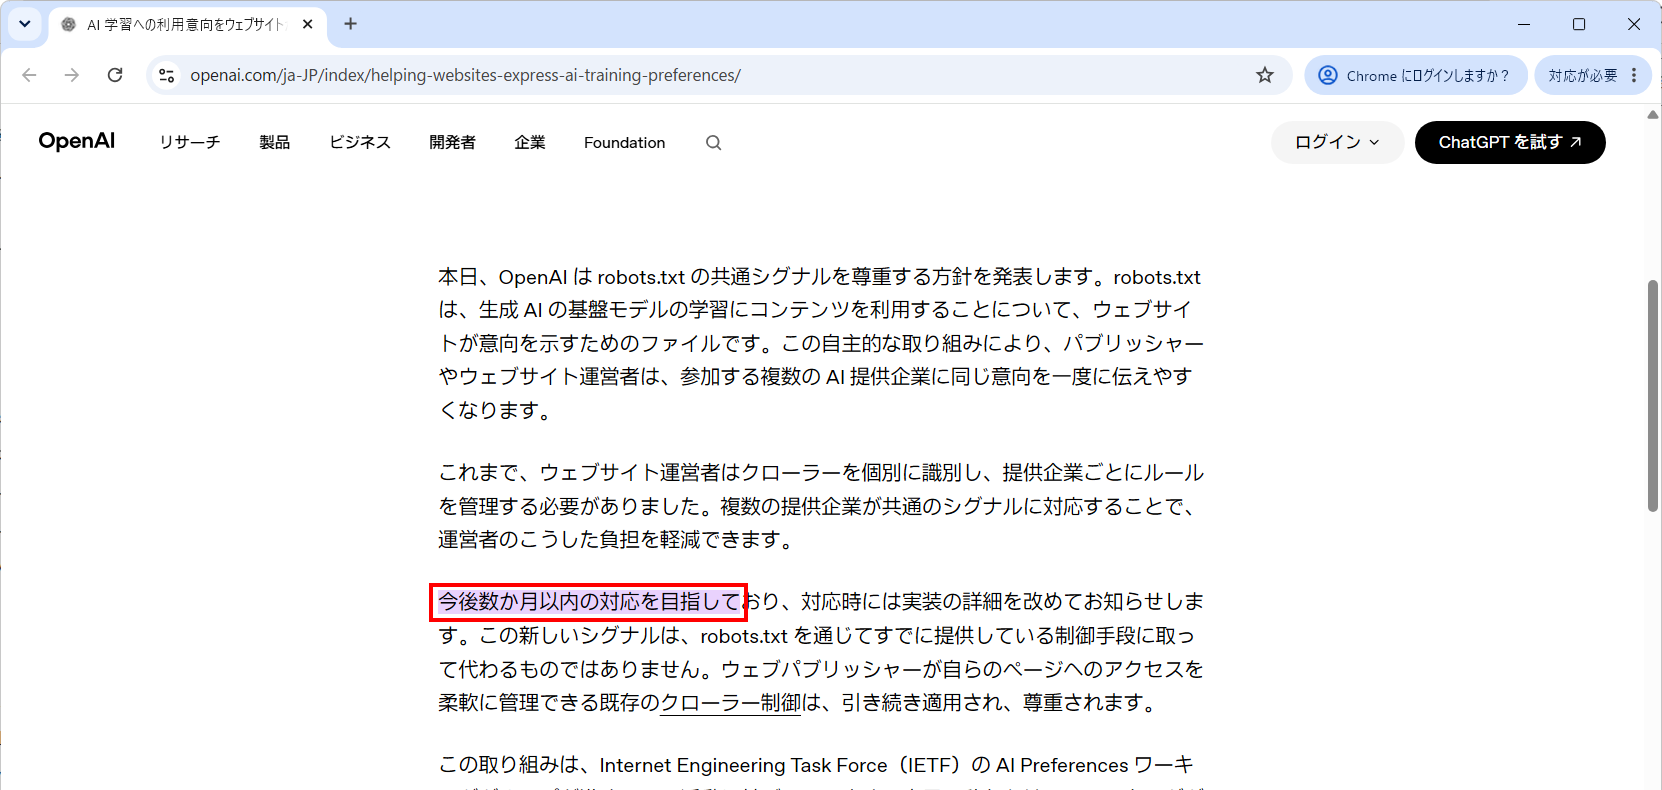
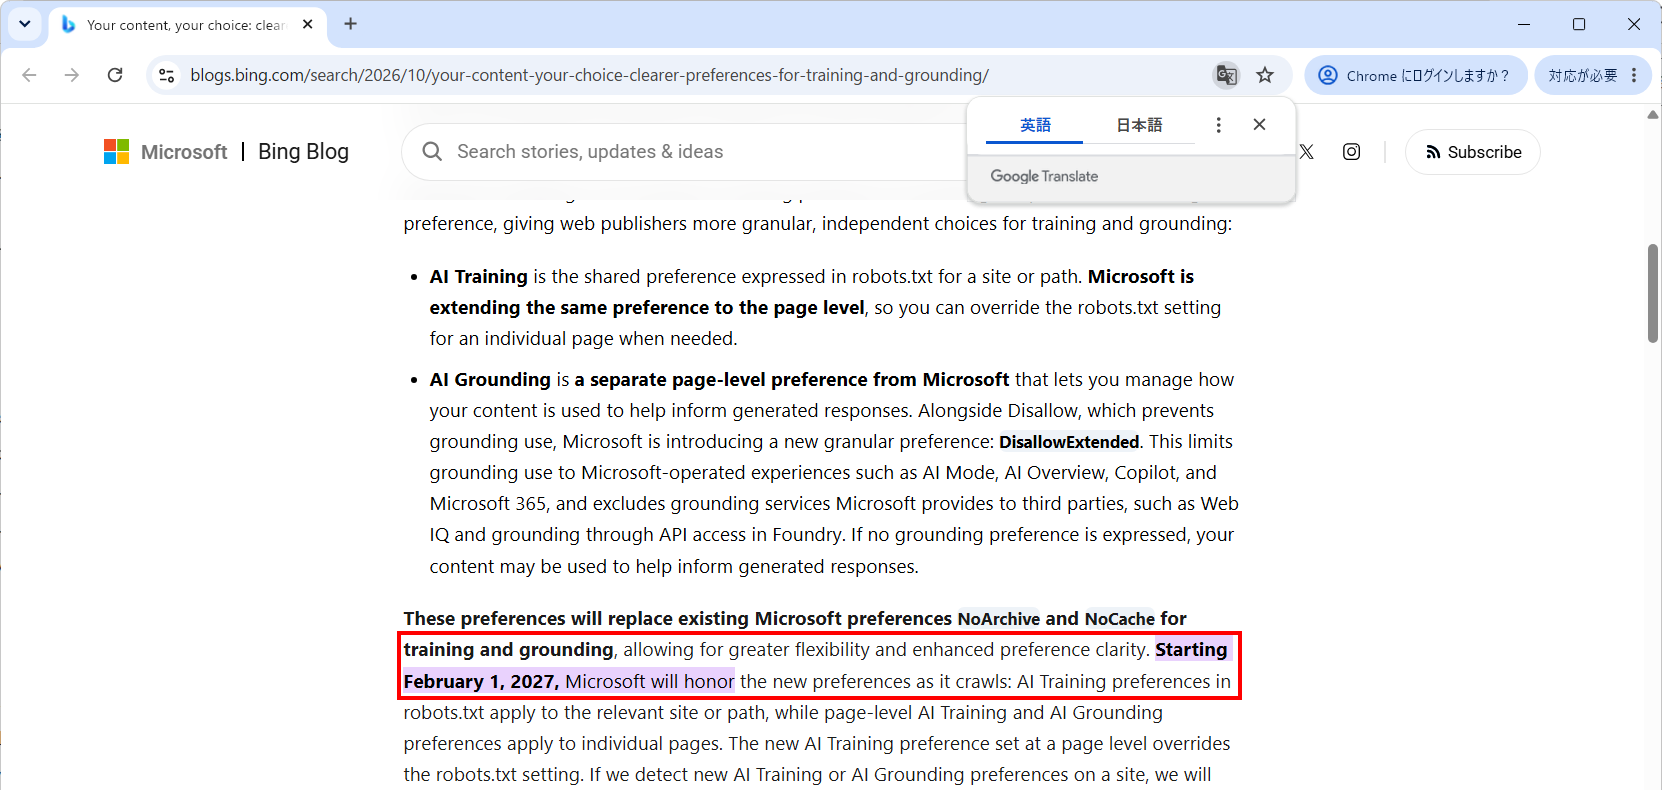
4社のうち、日付を示したのは Microsoft だけです。Microsoft の2月1日は、巡回して見つけた設定を読み始める日で、全サイトで効く日ではありません。
robots.txt に何を書くと、AIに学習されたくない意向を伝えられるの?
私が2026年11月2日に、私の PC(Windows 11 Home・ビルド 26200)で、草案の図1を解析器 protego に通しました。版は protego 0.7.0、Python 3.14.4 です。
robots.txt は、サイトの入口に貼る注意書きの紙です。新しい書き方は、誰への注意書きかを書く行に __usage_ai-training と指定します。図1はこうです。
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
Disallow は「学習に使わないでください」、Allow は「学習に使ってかまいません」という意向を表す行です。巡回そのものをやめさせる指示ではありません。出どころは草案 draft-kelley-aipref-training-preference-signalです。
User-Agent の1行だけでは、protego も urllib も許可と返しました。拒否を伝えるには、User-Agent と Disallow の2行が要ります。
通した結果、/press-kit/a.html は許可、/news/a.html は拒否と読めました。拒否は意向で、守らせる力はありません。
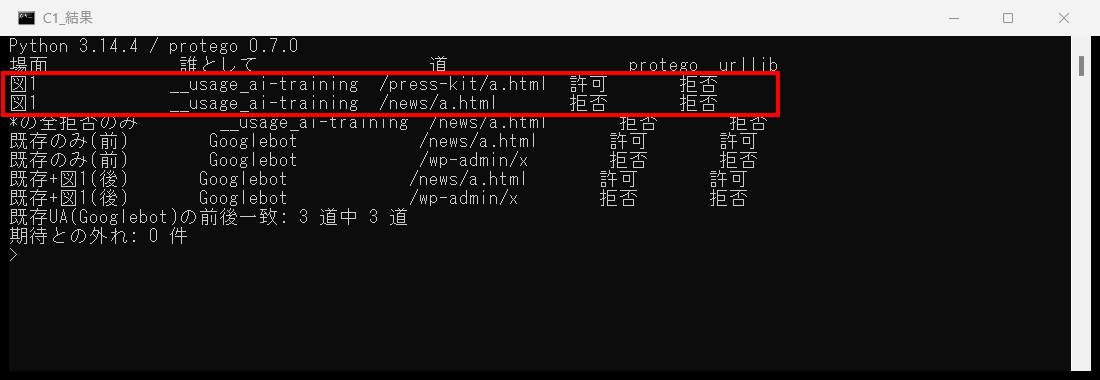
| 場面 | 誰として | 道 | protego | urllib |
|---|---|---|---|---|
| 図1 | __usage_ai-training | /press-kit/a.html | 許可 | 拒否 |
| 図1 | __usage_ai-training | /news/a.html | 拒否 | 拒否 |
| *の全拒否のみ | __usage_ai-training | /news/a.html | 拒否 | 拒否 |
| 既存のみ(前) | Googlebot | /news/a.html | 許可 | 許可 |
| 既存のみ(前) | Googlebot | /wp-admin/x | 拒否 | 拒否 |
| 既存+図1(後) | Googlebot | /news/a.html | 許可 | 許可 |
| 既存+図1(後) | Googlebot | /wp-admin/x | 拒否 | 拒否 |
7場面を2つの解析器に通し、期待との外れは0件でした。ただ、一番上の行で urllib と protego の答えが割れています(後の節)。
全部拒否の行を書いてあれば、AI学習も拒否したことになる?
ならない、というのが草案の読み方です。私の手元の解析では、全部拒否の行だけでも拒否と返りました(表の3行目)。けれど草案の4.2節は、全員向けの行を新しい指定名に当てはまらないものとして扱います。全部拒否の行だけでは、草案では「意向なし」です。拒否したいなら、__usage_ai-training の行を別に足します。

意向なしの扱いは会社で違い、Microsoft は許可が既定という書き方です。この食い違いは注意点です。詳しくはBing の発表(公式ブログ)にあります。
AI学習の拒否の行を足すと、検索結果から消えたり、巡回に影響したりする?
巡回をやめさせる指示とは書かれていません。ただし、会社が巡回の判断に使ってよいと、草案にあります。
※草案 draft-kelley-aipref-training-preference-signal(4.4節)
私が2026年11月2日に、私の PC で protego に、行を足す前と後の robots.txt を通しました。Googlebot 向けの判定は、/・/news/a.html・/wp-admin/x の3道とも同じでした(3道中3道)。前後の比べは protego だけで、urllib は比べていません。
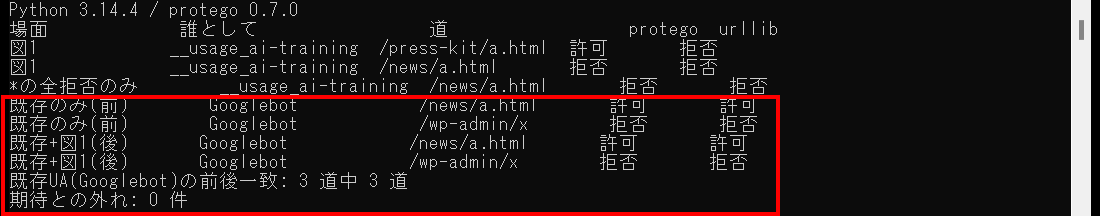
Google の実物では試していません。Google は、会社ごとの既存の設定が新しい共通の信号と並んで働き続けると説明しています(Google の発表(公式ブログ))。Bing の検索結果に残る資格は変わらないと、Microsoft は答えています。
注意点が1つあります。Microsoft の原文は、こう書いています。
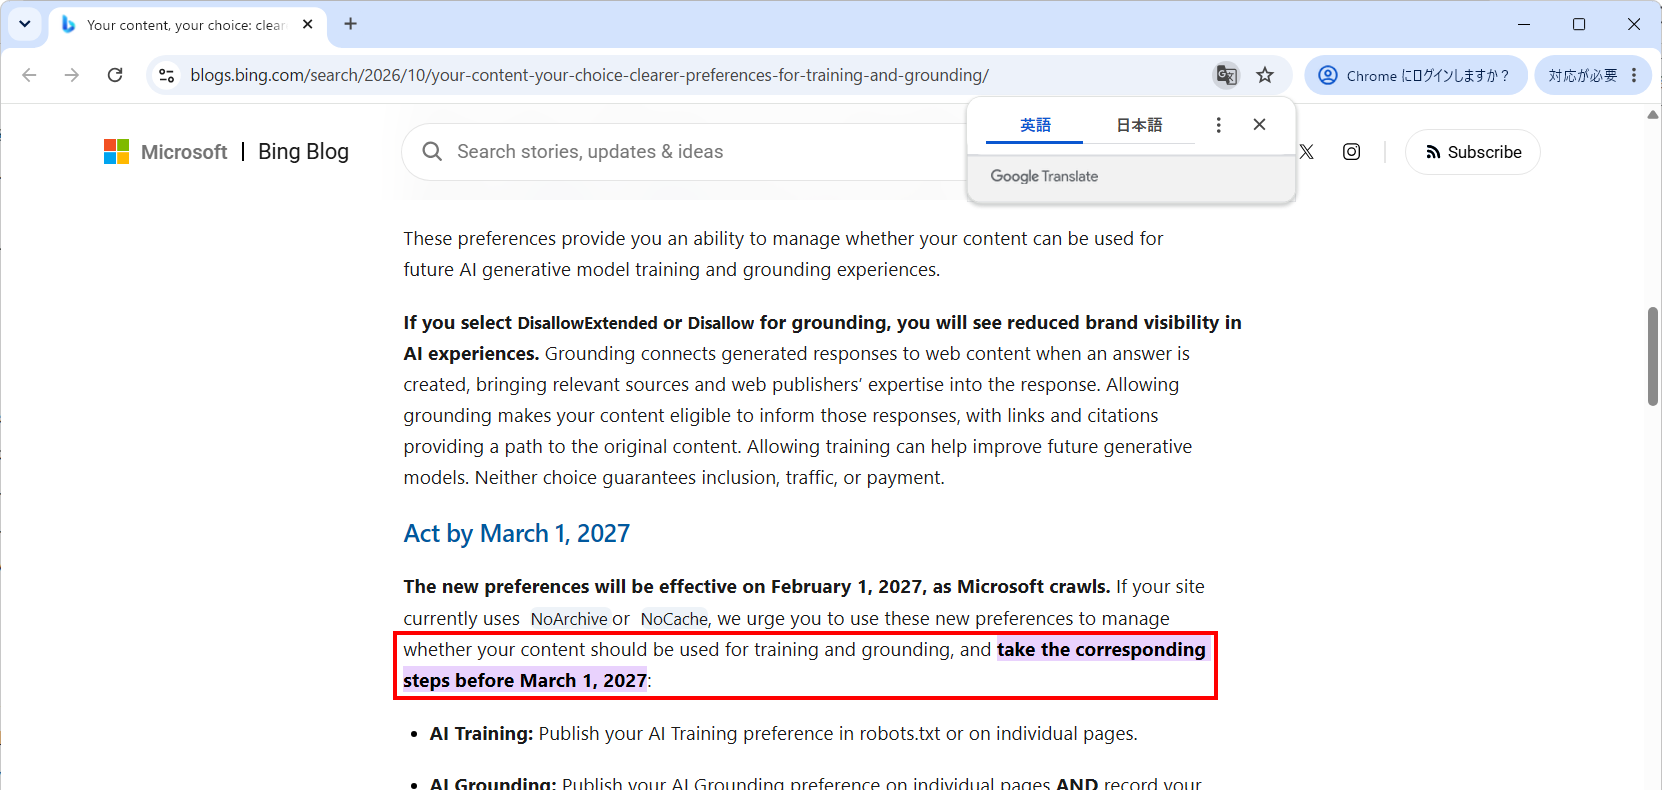
If we detect new AI Training or AI Grounding preferences on a site, we will disregard any NoArchive and NoCache preferences that may remain on that site.
新しい行を足すと、残っている NoArchive と NoCache が無視されうるという意味です。生成AIの回答への利用を断っていたサイトは、足す前にこの文を読んでください。この動きは、まだ起きていないので試せていません。
NoArchive/NoCache を使っているサイトは、Microsoft の2027年3月1日までに何をするの?
NoArchive と NoCache は、Bing 公式(2023年9月)が「AI の回答と学習への利用」を決める設定と説明している指定です。付けても、検索結果には出ます。これを使っているサイトだけが対応し、使っていないサイトに移行の作業はありません。
2027年3月1日は Microsoft だけの期限です。この日までに、学習は robots.txt か頁ごとの設定で意向を出し、グラウンディングは頁ごとの設定で出します(もう1つ別の手順があります)。手順の全文はBing の発表(公式ブログ)で確かめてください。
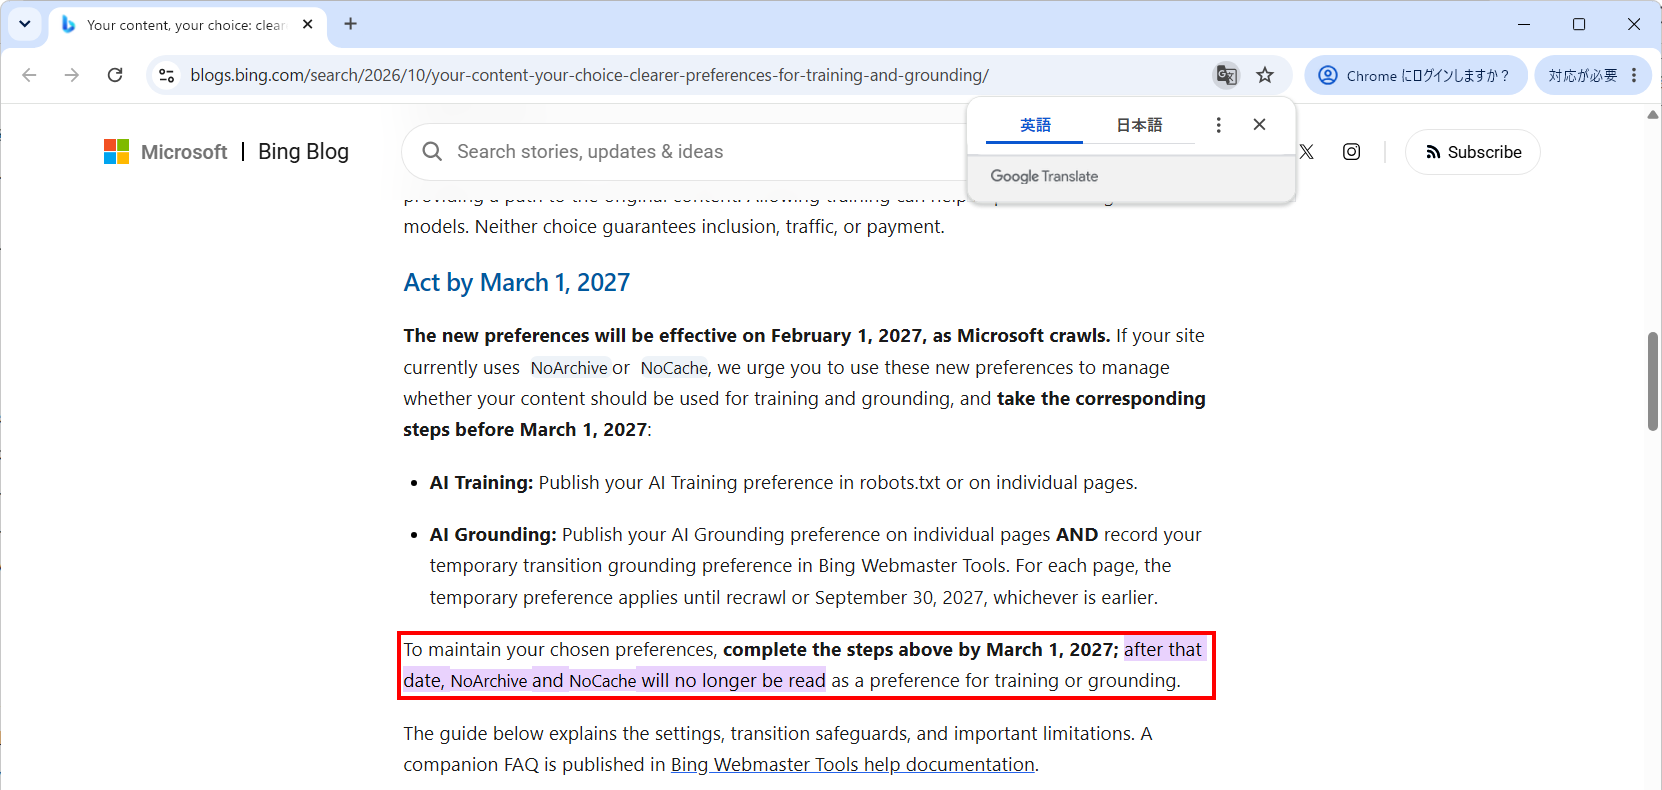
この日を過ぎると、Microsoft は NoArchive と NoCache を、学習とグラウンディングの設定として読まなくなります。ほかの会社の読み方まで言えるわけではありません。
Google の既存の設定を使っているサイトは、どうなるの?
Google には、別の注意点があります。Google は、こう書いています。
When a website uses this policy token to opt out of training in its robots.txt file (and Google-Extended is not explicitly specified), Google plans to interpret that as if the publisher had disallowed Google-Extended.
Google-Extended は、Google の既存の学習の設定です。Google-Extended を明示していると、そちらが優先され、既存の行と食い違うサイトでは新しい行が効きません。これは計画の話で、実際の動きはまだ試せません。
解析器によって、同じ robots.txt の読み方が割れるって本当?
本当です。同じ図1を Python 標準の urllib.robotparser に通すと、/press-kit/a.html は拒否、protego は許可でした。urllib は先に当たった行で決め、protego は長く合う行で決めます。この結果は参考で、各社が使う解析器ではありません。

長く合う行で決める読み方は、標準の RFC 9309 にあります(※RFC 9309(5.2節))。確認の道具で拒否と出ても、書き方の誤りとは限りません。Google のテスターなど、ほかの道具は試していません。
AI学習の拒否の書き方は、もう正式な決まりなの?
まだ正式な決まりではありません。草案は個人名義の -00 で、有効期限は2027年5月3日、書き方が変わる余地があります。
草案は、意向が付く時を「取得した時」と書いています(※草案 draft-kelley-aipref-training-preference-signal)。足すまでに取得された分には、取得した時の robots.txt の意向が当たります。足しても、もう取得や学習に使われた分を元に戻すとは、どの文書にも書かれていません。
結局、いま私は何をすればいいの?
今日やる1歩は、今の robots.txt を開いて控えを取るだけです。自分で編集できない人は、制作会社や社内の担当に、この2行を足すか聞いてください。NoArchive や NoCache を使っているなら、足す前にその有無を確かめてください。
この記事に出てくる言葉
| 語 | 意味 |
|---|---|
| robots.txt | サイトの入口に貼る、巡回する人への注意書きの紙 |
| グラウンディング | AI が答えるとき、サイトの内容を手元の資料として読んで使うこと。学習とは別 |
| 草案 | 決まりになる前の案。書き方が変わることがある |
| 意向 | 「こうしてほしい」というお願い。守らせる力は無い |
参考にした公式ページ
- Google の発表(公式ブログ)
- OpenAI の発表(日本語)
- Bing の発表(公式ブログ)
- 草案 draft-kelley-aipref-training-preference-signal
- IETF のメール(ai-control)
- ITmedia の記事
- RFC 9309