PDFを放り込んだ瞬間に「不明なエラーが発生しました」と返ってきて、作業が止まる。あの一瞬のイラッとする感じ、よくわかります。同じファイルなのに昨日は通ったのに今日は弾かれる、ということも珍しくありません。
実はこのエラー、原因は数えるほどしかありません。そして多くの人がつまずくのは「ファイルが悪い」のではなく、ChatGPT側の見えない制限に引っかかっているケースです。この記事では、まず30秒で自分のケースを切り分け、原因ごとに最短で直す手順をまとめました。2026年6月時点のOpenAI公式仕様で裏取りした内容なので、古い情報で遠回りする心配はありません。
結論 まず30秒で原因を切り分ける
闇雲に圧縮や再起動を試す前に、自分がどのパターンかを先に見極めると一発で終わります。下の流れに沿ってチェックしてください。
- 無料プランで今日すでに何度かファイルを上げていないか。無料は1日のアップロード回数に上限があり、これに当たると通りません。
- PDFがスキャン(紙をスキャナーで取り込んだ画像)でできていないか。文字を選択・コピーできないPDFは要注意です。
- ファイルが極端に大きく(数十MB以上)ないか、もしくは中身が膨大な文字数でないか。
- 上のどれでもなければ、ブラウザのキャッシュや一時的な不具合の可能性が高いです。
このうち1と2が、他の解説であまり強調されない「見落としがちな本当の原因」です。順番に見ていきます。
エラー文言で原因を見分ける早見表
ChatGPTが返すメッセージは、実は原因のヒントになっています。出た文言ごとに、まず疑うべき原因と対処をまとめました。
| 出たメッセージ・症状 | まず疑う原因 | 最短の対処 |
|---|---|---|
| 「不明なエラーが発生しました」 | 一時的な不具合・形式の相性 | 少し待って再送信、別ブラウザで試す |
| 添付しても回答に内容が反映されない | スキャンPDF(画像扱い) | 後述のテキスト化(OCR)をする |
| 上げた直後に弾かれる・回数を消費 | 無料プランの回数上限 | 翌日まで待つか有料プランを検討 |
| 読み込みが途中で止まる・タイムアウト | ファイルが大きい・回線 | 分割・圧縮、回線を切り替える |
| そもそも添付ボタンが押せない | 機能オフ・モデル選択 | 別のモデルに切り替え、再ログイン |
この表で当たりを付けてから対処すると、関係ない手順を試して時間を溶かさずに済みます。
原因1 無料プランの回数制限という見えない壁
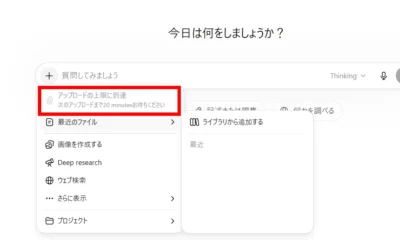
意外と知られていませんが、無料プランにはファイルアップロードの「1日あたりの回数」に上限があります。2026年6月時点で、無料(Free)はおおむね1日3ファイル、画像は1日2枚程度が目安です。ここを超えると、ファイル自体に問題がなくてもアップロードが通らなくなります。
「昨日はできたのに今日は弾かれる」「数回試したら急に上がらなくなった」というときは、ファイルを疑う前にこの制限を疑ってください。原因がこれなら、対処はシンプルです。日付が変わって枠が回復するのを待つか、頻繁に使うなら有料プランを検討する、のどちらかになります。Plus以上は回数の縛りがぐっと緩くなります。
なお無料でもPDFの読み込み自体は可能です。「無料だと一切PDFを扱えない」という古い情報を載せた記事もありますが、現在は無料でも回数の範囲内なら読み込めます。
原因2 スキャンPDFは中身が読まれていない
ここが多くの人が一番ハマるポイントです。紙の書類をスキャナーやスマホで取り込んだPDFは、見た目は文字でも、データの中身は「画像」です。
OpenAIの公式仕様(2026年6月時点)では、Enterprise以外の通常プランの場合、ChatGPTはアップロードしたファイルから「デジタルのテキストを抽出し、画像は破棄する」と明記されています。つまりスキャンPDFを上げても、文字情報が無いので中身が空っぽとして扱われ、要約や質問に答えられません。エラーにならず「アップロードは成功したのに内容に答えてくれない」という形で表れるのが厄介なところです。
見分け方は簡単で、PDFを開いて本文をマウスでドラッグ選択してみてください。文字が選択できればテキストPDF、できなければスキャン(画像)PDFです。
スキャンPDFだった場合は、OCR(画像の文字を読み取る技術)でテキスト化してから上げ直します。手軽なのは、PDFをGoogleドライブに入れてGoogleドキュメントで開き直す方法です。OCRが自動でかかり、文字として開きます。それをコピーしてChatGPTに貼り付けるか、テキストとして保存して上げ直せば読めるようになります。Adobe Acrobatや無料のオンラインOCRでも同じことができます。
原因3 サイズと文字数は別々の上限がある
| 上限の種類 | 目安 | 引っかかりやすい例 |
|---|---|---|
| ファイルサイズ | 1ファイル512MB | 高解像度のスキャン書類 |
| 文字数(トークン) | サイズとは別の大きな上限 | 超長文の資料 |
| 無料の回数 | 1日あたり数ファイル目安 | 短時間に連続アップロード |
※2026年6月時点の目安。最新は公式で確認してください。
「ファイルが大きいと弾かれる」は半分正解です。正確には、ChatGPTには性質の違う2種類の上限があります。
ひとつは純粋なファイルサイズで、公式では1ファイル512MBが上限です。これはかなり大きく、普通のPDFで超えることはまずありません。もうひとつが文字数(トークン)の上限で、テキスト系のファイルは1ファイル200万トークンまでとされています。文章がぎっしり詰まった長大なPDFは、サイズが小さくてもこの文字数の壁に当たります。
長文PDFを上げて「最初のほうしか要約してくれない」と感じるのは、この文字数上限が効いているからです。対処は、PDFを章ごとに分割して数回に分けて読み込ませる、もしくは必要なページだけ抜き出して上げることです。全部を一度に渡すより、読ませたい範囲を絞ったほうが精度も上がります。
サイズ自体が大きいときは、PDF編集ソフトやオンラインの圧縮ツールで画像の解像度を落として軽くすると通りやすくなります。
原因4 ブラウザと一時不具合の切り分け
ここまでのどれにも当てはまらないなら、環境側の一時的な問題です。試す順番は次の通りです。
最初にページの再読み込みと再送信。OpenAI側が混雑していると一時的に弾かれることがあり、数分待つだけで直る場合があります。次にブラウザのキャッシュ削除、もしくはシークレットウィンドウで試す。拡張機能が干渉していることもあるので、別ブラウザ(ChromeとEdgeを入れ替えるなど)で試すのも有効です。スマホアプリ版で詰まったときは、いったんブラウザ版に切り替えると通ることがあります。
最後に再ログイン。アカウントのセッションが切れかかっていると添付がうまく動かないことがあり、ログインし直すと解消するケースがあります。
よくある質問
無料プランでもPDFは読み込めますか
読み込めます。2026年6月時点では無料でもPDFのアップロードに対応していますが、1日あたりの回数に制限があります。連日たくさんのPDFを扱う使い方だと無料では足りなくなりやすく、その場合はPlus以上が現実的です。
スキャンしたPDFを読ませる一番簡単な方法は
GoogleドライブにアップロードしてGoogleドキュメントで開くと、OCRが自動でかかって文字として読み込まれます。そのテキストをコピーしてChatGPTに貼り付けるのが、追加ソフト不要で一番手軽です。
パスワード付きPDFは上げられますか
パスワードで保護されたPDFは中身を読み取れず、エラーや空の結果になります。先にパスワードを解除した状態で保存し直してから上げてください。
毎回同じファイルでエラーになります
特定のファイルだけ失敗するなら、そのPDFが破損しているか特殊な形式の可能性があります。一度PDFを開いて「印刷」から「PDFとして保存」で作り直す(再書き出しする)と、形式がリセットされて通ることが多いです。
PDFのアップロードでつまずいたら、まずは「無料の回数制限」と「スキャンPDFかどうか」の2つを先に疑ってください。この2つを押さえるだけで、多くのケースは数分で解決します。仕様や制限は更新されることがあるため、回数や上限の最新値は最終的にOpenAIの公式ヘルプで確認するのが確実です。